Исследователи предложили XConf: языковые модели оценивают уверенность по прошлому опыту
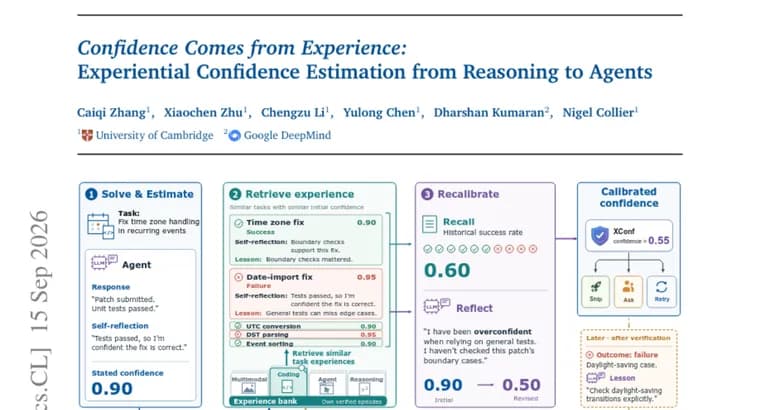
Существующие методы оценки уверенности языковых моделей опираются только на текущий процесс вывода: интроспекцию модели, вероятности токенов или повторную выборку ответов. Авторы новой работы утверждают, что одного текущего вывода недостаточно для надёжной оценки уверенности, и предлагают метод XConf (eXperiential Confidence, «уверенность из опыта»).
Опыт модели хранится как архив её прошлых оценённых эпизодов: для каждого, задача, собственная рефлексия модели, заявленная уверенность, итог (правильно или нет) и урок, сформулированный после получения оценки. Для новой задачи этап Recall в XConf находит похожие прошлые эпизоды с похожим уровнем заявленной уверенности и считывает их историческую долю успеха; этап Reflect показывает модели эту статистику, просит её назвать повторяющуюся ошибку и заново сформулировать уверенность, уже с учётом собственного «послужного списка».
Метод не привязан к формату задачи, не требует доступа к логитам модели или дообучения весов и стоит ровно одну дополнительную генерацию ответа.
На девяти бенчмарках, охватывающих рассуждения, кодинг, мультимодальные вопросы-ответы и интерактивных агентов, и на четырёх моделях из трёх семейств XConf превосходит или не уступает десятикратной самосогласованности (self-consistency) по различающей способности (AUROC) в 23 из 24 сравнений, при этом с заметно меньшей ошибкой калибровки (ECE) и при затратах на генерацию в десять раз меньше. При выборочном прогнозировании, отказе отвечать на 10% наименее уверенных эпизодов, XConf поднимает итоговую долю успеха на агентных задачах на величину до 8,7 пункта.
Авторы называют оценку уверенности на основе опыта новой парадигмой для будущих универсальных методов оценки уверенности языковых моделей.
Ключевые факты
- XConf оценивает уверенность языковой модели не только по текущему выводу, но и по архиву прошлых эпизодов: задача, рефлексия модели, заявленная уверенность, итог и урок.
- Работает в два этапа: Recall находит похожие прошлые эпизоды с похожей заявленной уверенностью и их историческую долю успеха; Reflect показывает эту статистику модели, чтобы она назвала повторяющуюся ошибку и уточнила уверенность.
- Метод не требует доступа к логитам модели или дообучения весов и стоит ровно одну генерацию ответа, против десяти генераций у self-consistency.
- На девяти бенчмарках (рассуждения, кодинг, мультимодальные QA, агентные задачи) и четырёх моделях из трёх семейств XConf обходит или не уступает десятикратной самосогласованности по AUROC в 23 из 24 сравнений при заметно меньшей ошибке калибровки.
- Отказ отвечать на 10% наименее уверенных эпизодов поднимает итоговую долю успеха на агентных задачах на величину до 8,7 пункта.
Почему это важно
Оценка уверенности определяет, что модель может отдать пользователю без проверки, что эскалировать человеку, а что стоит повторить заново, от этого зависит, насколько безопасно доверять её ответам в реальных системах. Существующие методы оценивают только текущий акт вывода; авторы утверждают, что этого недостаточно, и добавляют модели «память» о собственных прошлых успехах и ошибках.
Кому это важно
Разработчикам систем на базе языковых моделей, особенно там, где нужно решать, каким ответам можно доверять без проверки человеком: агентным системам, кодогенерации, интерактивным помощникам. Метод полезен именно там, где важна не только точность, но и калиброванная уверенность, когда высокая заявленная уверенность действительно совпадает с высокой долей правильных ответов.
Как это применить
XConf работает как надстройка поверх обычной генерации: не нужен доступ к логитам модели и не нужно дообучать веса, а стоимость, одна дополнительная генерация ответа вместо десяти при self-consistency. На практике это можно использовать для выборочного прогнозирования, отказа отвечать на долю наименее уверенных случаев, что в тестах авторов подняло долю успеха на агентных задачах на величину до 8,7 пункта.
Можно ли доверять
В источнике не указаны ни аффилиация авторов, ни конкретные названия использованных бенчмарков, ни идентичность четырёх протестированных моделей и трёх семейств, ни дата публикации, наличие кода или модели. Заявленные цифры, 23 из 24 сравнений, выигрыш по AUROC, десятикратная экономия на генерации, прирост до 8,7 пункта, это собственные результаты авторов на их же бенчмарках; независимого подтверждения пока нет.
Риски и подводные камни
Сравнение в источнике проведено только с одним базовым методом, десятикратной самосогласованностью (self-consistency), других базовых линий не названо. Само устройство метода, опора на архив прошлых эпизодов, означает, что качество оценки уверенности зависит от того, насколько репрезентативна и достаточна история прошлых задач; для принципиально новых типов задач, где прошлого опыта мало или нет, преимущество может быть меньше.