Dharma-AI выпустила Field Extractor: 2 млрд параметров, поля из документов в JSON
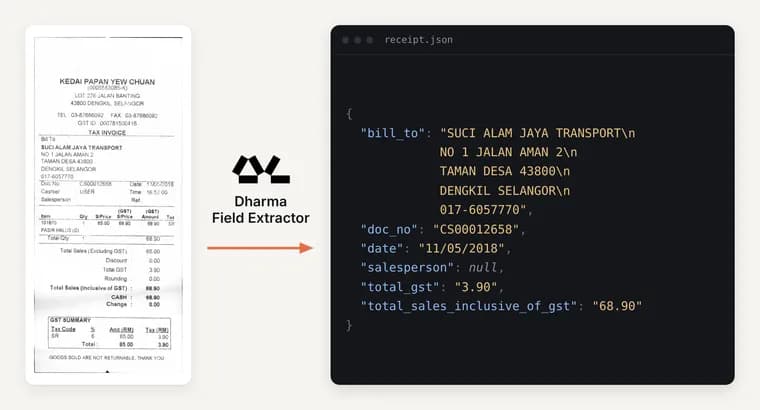
Dharma-AI опубликовала в блоге на Hugging Face описание Dharma Field Extractor: модели на 2 млрд параметров, которая принимает изображение документа и возвращает структурированный JSON с типизированными и, где нужно, вложенными полями. Идея в том, что обычное распознавание текста (OCR) отдаёт всё напечатанное на странице построчно и не говорит, какая строка является датой, типом обследования или итоговой суммой; сопоставлять значения с полями должен чей-то код. Универсальная большая нейросеть с этим справляется при аккуратном промпте, но по ценам и задержкам передовых API это дорогой способ решать чётко очерченную задачу, которую бизнесу нужно гонять в больших объёмах.
Модель работает в двух режимах. В открытом схему не задают: модель по контексту и вёрстке сама определяет, что является полем (подпись и значение, таблица с шапкой), и возвращает всё найденное парами «ключ, значение». В режиме со схемой пользователь описывает нужную структуру поле за полем, с типом для каждого (строка, число или булево значение) и под теми именами ключей, которые уже используются в его системе. Выдача повторяет схему точно: те же ключи, без лишних полей; таблицы заполняются по строкам и столбцам, а поле, которого в документе нет, возвращается как null, а не выдумывается. Один и тот же чекпойнт обрабатывает все типы документов без дообучения под каждый тип.
Обучение. Базой служит DharmaOCR-LITE v1.1, новая версия на 2 млрд параметров, оптимизированная относительно модели из статьи компании и уже специализированная под OCR через supervised fine-tuning и DPO. Поверх неё обучили LoRA-адаптер на 43 384 примерах для обоих режимов запроса. Данные собраны из трёх потоков: англоязычные документы из открытого веба разных типов, реальные бразильские документы на португальском, полученные компанией самостоятельно, и меньшая доля других европейских и азиатских языков. Все три потока размечены на уровне полей; набор намеренно разнородный: чеки, коммерческие счета, формы, банковские выписки, удостоверения личности и синтетические документы.
Бенчмарк. Полный набор включает 546 документов и три сценария запроса, всего 1 638 случаев: извлечение всех полей без схемы, частичная схема только с реальными полями и схема, куда добавлены заведомо несуществующие поля. Оценка, F1 на уровне полей (совпадение по пути, включая позицию в таблице), умноженная на сходство значений по Левенштейну и на долю ответов, которые являются валидным JSON. Тот же тест прогнали на четырёх универсальных передовых конфигурациях. Field Extractor набрал 0,834; у Claude Opus 5, 0,816, у GPT-5.6 Luna, 0,741. Разрыв по качеству составляет от 1,8 пункта (Claude Opus 5, ближайший) до 9,3 пункта (GPT-5.6 Luna, самый большой).
Стоимость. По оценке авторов, извлечение обходится примерно в 6 раз дешевле, чем у GPT-5.6 Luna, и примерно в 147 раз дешевле, чем у GPT-5.6 Sol. Авторы сами оговаривают, что стороны оценены по-разному: у передовых моделей стоимость посчитана по замеренным средним входным и выходным токенам на страницу (включая токены рассуждений) и опубликованным прайсам провайдеров, при этом все они работали с рассуждением на низком уровне, а Claude Opus 5, с адаптивным усилием. У Field Extractor стоимость, это время GPU на одной L40S по $2,24 в час при самостоятельном размещении. Это, подчёркивают авторы, не цена продажи: реальная стоимость зависит от железа, объёма и нужной задержки.
Примеры обобщения. SROIE и FUNSD, два публичных набора из бенчмарка, не использованных при обучении. На чеке из SROIE запросили все 18 напечатанных на нём полей, и, по словам авторов, все вернулись верно: многострочный адрес без подписи собран в одно поле, два пустых поля (продавец и ссылка) возвращены как null, все числа совпали до копейки. На форме FUNSD о качестве фотокопирования, чек-листе из двенадцати булевых полей с вложенной группой из пяти подпунктов, модель отметила true ровно единственную отмеченную позицию (плохое качество оригинала с рукописной пометкой «faded»), остальные одиннадцать, false, верно считала рукописный идентификатор Bates и вернула null для двух пустых полей.
Вывод авторов. Они напоминают, что первая DharmaOCR-LITE на 3 млрд параметров в их статье опередила коммерческие передовые API на бразильском португальском, а через три месяца появились новые и более ресурсные модели, но разрыв сохранился. Теперь, по их словам, то же сделала модель на 2 млрд параметров в извлечении полей. Это подкрепляет тезис компании: на ограниченной задаче малая модель, обученная близко к ней, лучше передовой модели, которую просят делать то же самое в общем виде. Завершается пост утверждением, что бизнесу нужна не самая большая модель, а обученная под его задачу, и ссылкой на демо.
Ключевые факты
- Dharma Field Extractor, модель на 2 млрд параметров: по изображению документа возвращает JSON либо в открытом режиме (без схемы), либо строго по заданной схеме; поля, которых нет в документе, получают null.
- На собственном бенчмарке Dharma-AI (546 документов, 1 638 случаев, три сценария запроса) модель набрала 0,834 против 0,816 у Claude Opus 5 и 0,741 у GPT-5.6 Luna; разрыв с четырьмя протестированными передовыми конфигурациями, от 1,8 до 9,3 пункта.
- Заявленная экономия, примерно от 6 раз (к GPT-5.6 Luna) до 147 раз (к GPT-5.6 Sol); сравнивается время GPU на одной L40S по $2,24 в час с прайсами API, поэтому сопоставление неравноценное, как признают и сами авторы.
- Основа, DharmaOCR-LITE v1.1 (2 млрд параметров) плюс LoRA-адаптер, обученный на 43 384 примерах: английские веб-документы, реальные бразильские документы на португальском и меньшая доля других языков.
- Обобщение показано на двух публичных наборах, не входивших в обучение: чек SROIE (18 полей, все верны по словам авторов) и форма FUNSD (12 булевых полей, отмечена только одна верная позиция).
Почему это важно
Задача «достать из документа конкретные поля в нужном формате» массовая: счета, медицинские направления, удостоверения, договоры. Dharma-AI показывает, что для неё можно обойтись небольшой специализированной моделью вместо дорогого вызова передового API и отдельного кода сопоставления значений с полями. Компания продолжает линию своей предыдущей работы по DharmaOCR-LITE и подаёт результат как ещё одно подтверждение тезиса, что на узкой задаче малая модель, обученная близко к ней, бьёт универсальную. Отдельная ценность для интеграции: выдача строго повторяет заданную схему, а отсутствующие поля возвращаются как null, а не выдумываются.
Кому это важно
Командам, которые обрабатывают большие потоки однотипных документов: бухгалтерия и финансы (счета и чеки), медицинские сервисы (направления на обследования), HR (удостоверения личности для карточки сотрудника), юридические и комплаенс-отделы (стороны, сроки, штрафы из договоров). Также интересно тем, кто размещает модели на собственной инфраструктуре и считает стоимость обработки одной страницы. Отдельно отметим акцент авторов на бразильских документах на португальском: для них заявлены реальные данные в обучении.
Как это применить
Выбор режима зависит от того, что вы знаете заранее. Если не известно, что содержит документ, посылайте открытый запрос без схемы. Если результат должен лечь в уже существующую структуру (поля базы данных, колонки таблицы), задавайте схему: перечислите поля с типами string, number или boolean под нужными именами ключей. Пост содержит ссылку на демо «попробуйте на своих документах» (в тексте, только подпись ссылки). Лицензия и возможность скачать веса в самом посте не указаны; для своего размещения стоит уточнить это у Dharma-AI. Авторы приводят расчёт стоимости на одной видеокарте L40S по $2,24 в час, но подчёркивают, что реальная цена зависит от железа, объёма и допустимой задержки.
Можно ли доверять
Это публикация самого разработчика в собственном блоге, а бенчмарк составлен и прогнан самой Dharma-AI; независимой проверки в посте нет. Заявлено, что SROIE и FUNSD не использовались в обучении, но остальные части бенчмарка и его публичность из текста не ясны. Приведены оценки только для Claude Opus 5 (0,816) и GPT-5.6 Luna (0,741); баллы GPT-5.6 Sol и четвёртой конфигурации не названы, сама четвёртая конфигурация не поименована. Не приведены разбивка по трём сценариям, доверительные интервалы и число прогонов. Разрыв по качеству невелик (1,8 пункта к лучшему из названных), а сравнение стоимости, как признают авторы, неравноценное: время GPU при самостоятельном размещении против токенов по прайс-листу. Показанные примеры по SROIE и FUNSD, по одному на набор, выбранные авторами.
Риски и подводные камни
Цифры 6 и 147 раз нельзя читать как готовую экономию: они сравнивают самохостинг на одной L40S с ценами API, а в реальности добавятся расходы на эксплуатацию, загрузку железа и задержку. Все передовые модели запускались с рассуждением на низком уровне, и при другой настройке результат мог бы отличаться. Абсолютных затрат на страницу и данных о задержках в посте нет. Схема допускает только три типа значений (строка, число, булево), так что сложные случаи придётся укладывать в них. Качество на ваших документах, особенно непохожих на обучающие потоки (английские, бразильские португальские, меньшая доля прочих языков), стоит проверять на собственной выборке до внедрения.
«Число параметров задаёт потолок; обучение решает, какую его часть модель достигает на вашей задаче.»
— Dharma-AI, блог на Hugging Face