WorldBridge: роботы-манипуляторы обобщают задачи через видео и действия
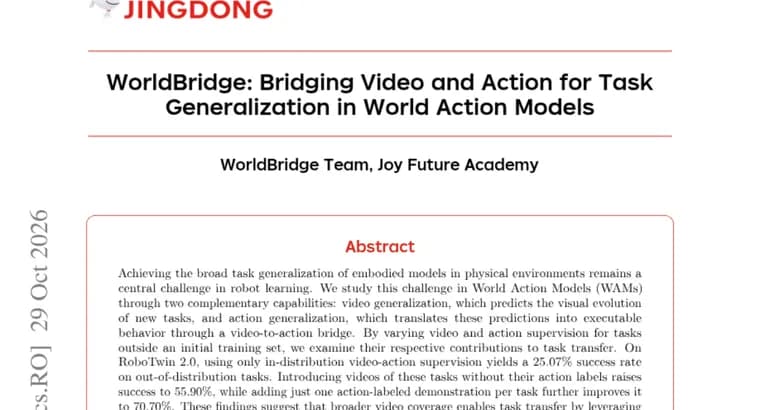
Препринт посвящён тому, как научить воплощённые модели (роботов, действующих в физическом мире) переносить навыки на новые задачи. Авторы изучают это на моделях класса World Action Models (WAM) и выделяют две взаимодополняющие способности: обобщение на уровне видео (предсказание того, как визуально будет развиваться новая задача) и обобщение на уровне действий (перевод этих предсказаний в исполнимое поведение через «мост» от видео к действию).
Чтобы понять вклад каждой из них, авторы варьировали видео- и action-supervision (надзор в виде видео и в виде размеченных действий) для задач, не входивших в исходную обучающую выборку. На бенчмарке RoboTwin 2.0 обучение только на видео и действиях для задач из исходного распределения даёт 25,07% успеха на задачах вне распределения. Если добавить видео этих задач без меток действий, успех растёт до 55,90%. Если затем добавить всего одну демонстрацию с метками действий на каждую задачу, результат поднимается до 70,70%.
Авторы делают из этого вывод: более широкое покрытие видео позволяет переносить задачи, опираясь на уже имеющиеся способности обратной динамики (inverse dynamics, восстановление действий по смене кадров), а даже редкий надзор действиями эти способности усиливает.
Исходя из этого, они представляют WorldBridge, WAM с раздельными экспертами для видео и для действий, которые связаны структурированным вниманием и обучаются совместным flow matching. В модель входят визуальная память на двух временных масштабах и action forcing, а также единый конвейер обработки данных, который стандартизирует и фильтрует разнородные траектории роботов и надзор, полученный из рук на эгоцентричных (от первого лица) видео.
По заявлению авторов, на нескольких бенчмарках манипуляции WorldBridge показывает лучший результат среди сравниваемых методов: 96,23% на RoboTwin 2.0 в режиме полных данных, 80,9% в настройке «clean to random» на том же бенчмарке, 82,8% на RoboCasa GR1 TableTop и 57,6% на DOMINO Level-1. Итог работы, вывод о взаимодополняющих ролях предсказания видео и привязки к действиям при создании роботов, способных обобщать на разные задачи.
Ключевые факты
- Обобщение в World Action Models разделено на две способности: видео (предсказание хода новой задачи) и действия (перевод предсказания в исполнимое поведение).
- На RoboTwin 2.0 для задач вне распределения: 25,07% успеха без их видео, 55,90% с видео без меток действий, 70,70% после добавления одной демонстрации с метками действий на задачу.
- WorldBridge: раздельные эксперты видео и действий, структурированное внимание, совместный flow matching, визуальная память на двух масштабах времени, action forcing.
- Заявлен лучший результат среди сравниваемых методов: 96,23% (RoboTwin 2.0, полные данные), 80,9% (clean to random), 82,8% (RoboCasa GR1 TableTop), 57,6% (DOMINO Level-1).
- В обучении используется единый конвейер данных для разнородных траекторий роботов и надзора из рук на эгоцентричных видео.
Почему это важно
Главная проблема обучения роботов, перенос навыков на задачи, которых не было в обучении. Работа показывает на бенчмарке RoboTwin 2.0, что видео новых задач даже без меток действий резко повышает успех на них (с 25,07% до 55,90%), а единственная размеченная демонстрация на задачу добавляет ещё до 70,70%. Это указывает на то, что дешёвые видеоданные могут быть важной частью обобщения. Это вывод авторов препринта.
Кому это важно
Исследователям робототехники и воплощённых моделей, а также командам, которые собирают данные для обучения манипуляторов: работа говорит о соотношении ценности видео и размеченных действий.
Как это применить
В тексте нет сведений о выпуске кода или модели, поэтому прямого применения пока нет. Практическая идея, которую предлагают авторы: сначала расширять покрытие задач видео, а размеченные действия добавлять в небольшом объёме, по одной демонстрации на задачу.
Можно ли доверять
Это препринт, и у нас есть только его аннотация. Заявление о лучшем результате ограничено «сравниваемыми методами», а в аннотации не названы метрики для 96,23%, 80,9%, 82,8% и 57,6%, а также конкретные методы сравнения и размер улучшения. Вывод о роли обратной динамики сформулирован авторами как предположение («suggest»).
Риски и подводные камни
Все приведённые результаты получены на бенчмарках (RoboTwin 2.0, RoboCasa GR1 TableTop, DOMINO); опытов на реальных роботах в аннотации не упомянуто. Число задач в наборе вне распределения и в обучающем наборе не указано, поэтому переносить цифры на другие условия нужно осторожно.