CaPtain: малую модель Qwen3.5-4B научили управлять роботом через код
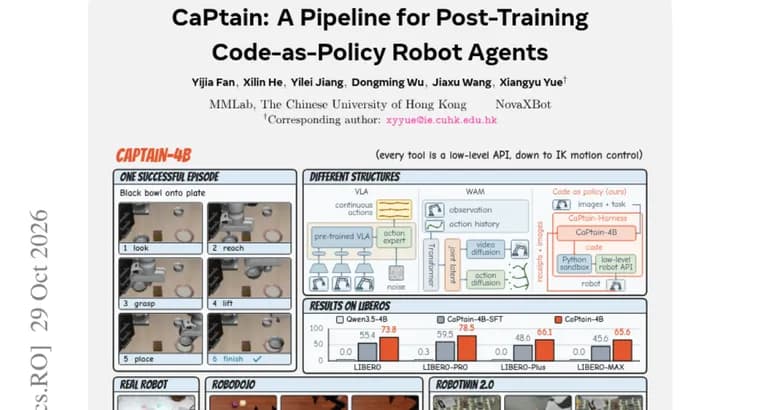
В препринте представлен CaPtain: открытый конвейер дообучения, который превращает небольшую открытую визуально-языковую модель (VLM) в агента «код как политика» (code-as-policy, CaP). В этом подходе управление манипулятором устроено как у ИИ-агентов для программирования и работы с сайтами: модель пишет код под API робота и читает результаты его выполнения. Для таких агентов обычно применяют двухшаговый рецепт: сначала обучение с учителем (SFT), затем многоходовое обучение с подкреплением (RL).
По словам авторов, существующие CaP-агенты обходят обучение стороной: они либо подают запросы закрытым передовым моделям, либо перекладывают управление манипулятором на готовые модели «зрение, язык, действие» (VLA) и высокоуровневые навыки, а небольшие открытые VLM в такой задаче попросту не справляются.
CaPtain обучает и запускает политику внутри среды CaPtain-Harness, которая даёт низкоуровневые примитивы восприятия, геометрии и «охраняемого» движения как в симуляции, так и на реальном оборудовании. Сначала базовую модель выравнивают через SFT на синтетических траекториях, сгенерированных с помощью GPT-6 Astra, затем применяют многоходовой RL. Главная трудность RL здесь в том, что нужно распределить заслугу между десятками запросов агента, физический эффект которых часто проявляется спустя несколько ходов, по единственному итогу эпизода. Для этого авторы вводят «физического критика»: он видит привилегированное состояние симулятора, недоступное самой политике, и оценивает каждый запрос по тому, насколько тот меняет предсказанную вероятность успеха.
Результаты. Модель стартует с Qwen3.5-4B, у которой в режиме zero-shot (без дообучения) успех равен 0%. После SFT CaPtain-4B достигает 55,4% успеха на отложенной выборке LIBERO, после RL, 73,8%. На LIBERO-PRO результат составляет 78,5%, что, по утверждению авторов, выше нескольких агентов на передовых моделях; прирост от RL сохраняется на трёх наборах возмущений (от +17,6 до +21,2 п.п.). Без обучения в целевой области модель набирает 83,3% на SimplerEnv WidowX, по утверждению авторов превосходит передовые модели на CaP-Bench и работает на реальном роботе после адаптации только в симуляции. Во время работы не нужны ни VLA, ни передовая модель, ни привилегированное состояние. Авторы заявляют, что публикуют весь код, данные и веса модели.
Ключевые факты
- CaPtain, открытый конвейер дообучения: SFT на синтетических траекториях (сгенерированных с помощью GPT-6 Astra), затем многоходовой RL с «физическим критиком».
- Базовая Qwen3.5-4B в режиме zero-shot даёт 0%; CaPtain-4B достигает 55,4% успеха на отложенной выборке LIBERO после SFT и 73,8% после RL.
- На LIBERO-PRO результат 78,5%, на SimplerEnv WidowX, 83,3% без обучения в целевой области; прирост от RL на трёх наборах возмущений, от +17,6 до +21,2 п.п.
- При запуске не нужны VLA, передовая модель или привилегированное состояние; критик использует скрытое состояние симулятора только при обучении.
- Авторы утверждают, что модель превосходит ряд передовых моделей и работает на реальном роботе после адаптации только в симуляции; обещают открыть код, данные и веса.
Почему это важно
Идея в том, чтобы управление роботом через код учили теми же методами, что и ИИ-агентов для программирования и веба, а не опирались на закрытые передовые модели или готовые VLA. Прыжок с 0% у исходной Qwen3.5-4B до 73,8% на LIBERO после RL показывает, что даже модель на 4 млрд параметров может стать рабочим агентом такого типа. Отдельно любопытен физический критик: он решает проблему распределения заслуги по десяткам запросов, чьи эффекты проявляются с задержкой.
Кому это важно
Исследователям робототехники и обучения с подкреплением, которым нужен воспроизводимый открытый рецепт для CaP-агентов, а также командам, которые не хотят зависеть от закрытых API при управлении манипуляторами. Интересно и тем, кто занимается многоходовым RL для агентов в целом: подход с критиком, видящим скрытое состояние симулятора, можно сопоставить с другими способами оценки промежуточных шагов.
Как это применить
Авторы заявляют, что публикуют весь код, данные и веса модели; ссылка на репозиторий в тексте аннотации не приведена. Рецепт состоит из двух этапов: SFT на синтетических траекториях, затем многоходовой RL с физическим критиком внутри среды CaPtain-Harness, которая даёт примитивы восприятия, геометрии и охраняемого движения для симуляции и реального оборудования. Для запуска обученной политики не нужны VLA, передовая модель или привилегированное состояние.
Можно ли доверять
Это препринт: все цифры приведены самими авторами, независимой проверки в тексте нет. Сильные сравнения («превосходит несколько агентов на передовых моделях», «превосходит передовые модели на CaP-Bench») подаются без названий моделей и их результатов, поэтому оценить масштаб преимущества по аннотации нельзя. Для результата на реальном роботе не приведён показатель успеха. Также стоит учесть, что синтетические траектории для SFT получены с помощью GPT-6 Astra, то есть обучение всё же опирается на сильную закрытую модель, хотя при запуске она не нужна.
Риски и подводные камни
Основные результаты получены в симуляции на бенчмарках (LIBERO, LIBERO-PRO, SimplerEnv WidowX, CaP-Bench), а перенос на реальный робот описан лишь общей фразой. Физический критик использует привилегированное состояние симулятора, поэтому метод привязан к среде, где такое состояние доступно. Данные для SFT зависят от внешней модели-генератора. Сведений о затратах на обучение, объёме данных и количестве траекторий в аннотации нет, поэтому оценить стоимость воспроизведения заранее трудно.