Whisper: энкодер обрезали на 6 слоёв и восстановили точность дистилляцией
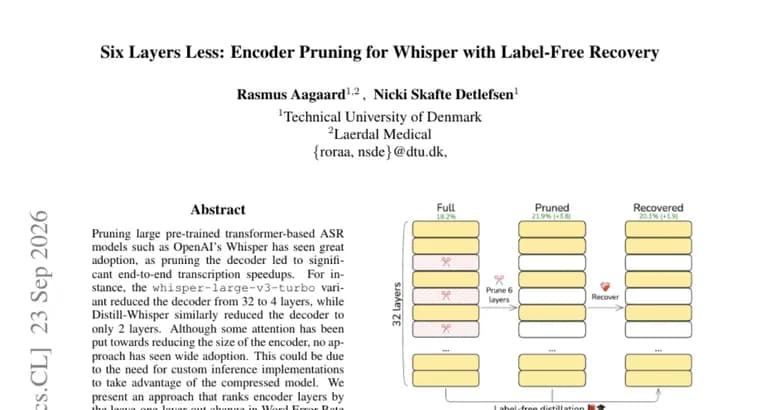
Обрезка декодера в моделях распознавания речи на основе Whisper от OpenAI уже широко применяется: например, в варианте whisper-large-v3-turbo декодер сократили с 32 до 4 слоёв, а в Distill-Whisper, всего до 2 слоёв, что даёт заметное ускорение транскрибации. Энкодер же так активно не обрезали: по мнению авторов работы, это могло быть связано с тем, что для использования преимуществ сжатой модели требовался нестандартный код инференса.
Авторы предлагают метод, который ранжирует слои энкодера по тому, насколько сильно меняется частота ошибок в словах (Word Error Rate, WER) при поочередном исключении каждого слоя (leave-one-layer-out). Шесть слоёв, дающих наименьшее изменение WER, удаляются полностью, это соответствует 18,5% всего стека энкодера. Поскольку модель после такой обрезки, это просто более неглубокий энкодер с меньшим числом слоёв, никакого специального кода для инференса не нужно.
Удаление слоёв в режиме zero-shot (без дообучения) ухудшает точность: средний WER по четырём языкам (какие именно языки, не уточняется) вырастает с базовых 18,2% до 21,9%. Чтобы частично вернуть точность, авторы применили дистилляцию на неразмеченных монолингвальных аудиоданных речи, то есть без опоры на текстовую разметку. После такой дистилляции средний WER снижается до 20,1%, оставаясь всё же выше исходного базового уровня в 18,2%.
Авторы выложили в открытый доступ код метода (на GitHub, репозиторий rasgaard/whisper-encoder-layer-prune) и уже обрезанную модель на основе whisper-large-v3-turbo (на Hugging Face, rasgaard/whisper-large-v3-turbo-encoder-pruned).
Ключевые факты
- Метод ранжирует слои энкодера Whisper по изменению WER при поочередном исключении каждого слоя и удаляет шесть слоёв с наименьшим влиянием, 18,5% стека энкодера
- Обрезанная модель не требует специального кода инференса: это просто более мелкий энкодер
- Zero-shot после обрезки: средний WER по четырём языкам вырос с 18,2% (база) до 21,9%
- Дистилляция на неразмеченных монолингвальных аудиоданных снизила WER до 20,1%, но не до исходного уровня
- Код и обрезанная модель (на базе whisper-large-v3-turbo) выложены в открытый доступ на GitHub и Hugging Face
Почему это важно
Обрезка декодера у моделей семейства Whisper (32→4 слоя у whisper-large-v3-turbo, 32→2 у Distill-Whisper) уже дала заметные ускорения и широко прижилась, а вот сжатие энкодера, нет, потому что для этого обычно нужен нестандартный код инференса. Предложенный подход убирает это препятствие: обрезанная модель, просто более неглубокий энкодер, который запускается тем же кодом, что и обычный Whisper.
Кому это важно
Инженерам и командам, которые разворачивают Whisper для распознавания речи в продакшене и хотят ускорить или удешевить инференс без переписывания инфраструктуры под кастомную архитектуру модели.
Как это применить
Авторы выложили и код метода ранжирования слоёв (GitHub, rasgaard/whisper-encoder-layer-prune), и готовую обрезанную модель на основе whisper-large-v3-turbo (Hugging Face, rasgaard/whisper-large-v3-turbo-encoder-pruned), их можно взять напрямую или применить методику ранжирования к другим вариантам Whisper.
Можно ли доверять
В доступном тексте источника не указаны имена авторов, их организация и дата публикации, это ограничивает независимую проверку контекста работы. При этом сам метод и результаты подкреплены выложенными в открытый доступ кодом и обученной моделью, что позволяет любому проверить заявленные цифры на практике.
Риски и подводные камни
Точность после дистилляции (WER 20,1%) не возвращается к исходному базовому уровню (18,2%), часть деградации от обрезки остаётся. Не названы конкретные четыре языка, на которых считался WER, и не приведён объём неразмеченных аудиоданных, использованных для дистилляции. Также не даны замеры скорости или задержки именно для обрезанного энкодера, ускорение количественно не подтверждено, в отличие от цитируемых цифр по обрезке декодера у других моделей.