WeVisForensics: агенты ищут следы ИИ в видео, точность 95,2%
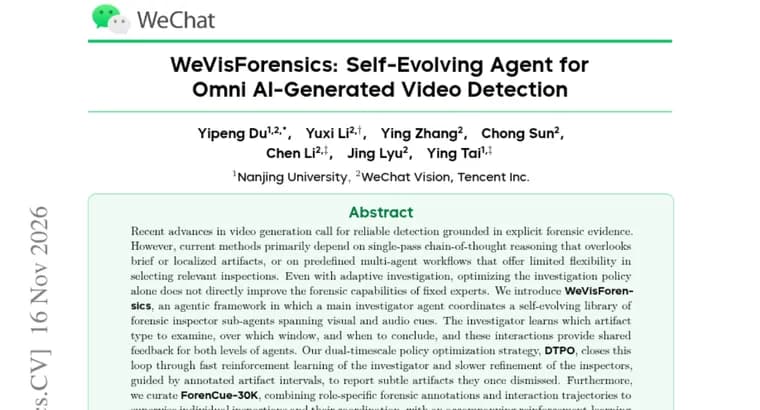
Авторы статьи на Hugging Face Papers предлагают WeVisForensics, агентную систему для распознавания видео, сгенерированных нейросетью. Исходная проблема, по их описанию: видеогенерация быстро развивается, и детекторам нужны надёжные выводы, опирающиеся на явные криминалистические улики. Существующие методы, как считают авторы, либо полагаются на однопроходное рассуждение по цепочке мыслей (chain-of-thought), которое упускает короткие или локальные артефакты, либо работают по заранее заданным многоагентным сценариям, где мало гибкости в выборе нужных проверок. Даже при адаптивном расследовании оптимизация одной лишь политики расследования, пишут они, напрямую не улучшает криминалистические способности «фиксированных экспертов».
Устройство системы. В WeVisForensics главный агент-следователь (investigator) координирует самообучающуюся библиотеку агентов-инспекторов, которые охватывают визуальные и звуковые признаки подделки. Следователь учится выбирать, какой тип артефакта проверять, на каком отрезке видео и когда пора выносить вердикт. Эти взаимодействия дают общую обратную связь обоим уровням агентов.
Обучение. Для замыкания этой петли авторы предлагают стратегию оптимизации политики с двумя временными масштабами, DTPO (dual-timescale policy optimization). Следователь обучается быстро, с помощью обучения с подкреплением, а инспекторы дорабатываются медленнее. Доработка идёт по размеченным интервалам с артефактами, чтобы инспекторы сообщали о тонких артефактах, которые раньше отбрасывали. Дополнительно авторы собрали набор данных ForenCue-30K: он объединяет ролевые криминалистические разметки и траектории взаимодействий, чтобы обучать с учителем отдельные проверки и их координацию, и включает пул для обучения с подкреплением.
Результат. По заявлению авторов, WeVisForensics в среднем достигает 95,2% точности обнаружения на внутридоменных, внедоменных и агентных бенчмарках, на 9,0% выше сильнейшего из прежних детекторов. При этом система обосновывает вердикты локализованными уликами. Из текста не ясно, что именно означают 9,0% (процентные пункты или относительный прирост), какие бенчмарки и конкурирующие методы взяты и какова точность лучшего из прежних детекторов.
Ключевые факты
- WeVisForensics, агентная система: главный агент-следователь координирует самообучающуюся библиотеку агентов-инспекторов, которые проверяют визуальные и звуковые признаки подделки.
- Стратегия обучения DTPO сочетает быстрое обучение с подкреплением следователя и более медленную доработку инспекторов по размеченным интервалам с артефактами.
- Авторы собрали набор данных ForenCue-30K: ролевые криминалистические разметки и траектории взаимодействий плюс пул для обучения с подкреплением.
- Заявленная средняя точность, 95,2% на внутридоменных, внедоменных и агентных бенчмарках, на 9,0% выше сильнейшего прежнего детектора.
- Система обосновывает вердикты локализованными уликами, а не только выдаёт итоговый ответ.
Почему это важно
Видеогенерация развивается быстро, и по описанию авторов детекторы должны опираться на явные криминалистические улики, а не только на общее впечатление. Предлагаемая идея, не одна модель-судья, а иерархия: главный агент решает, что и где проверять, а специализированные инспекторы сами улучшаются по результатам расследований. Авторы подчёркивают, что оптимизации одной лишь политики расследования недостаточно: нужно развивать и самих экспертов. Такой подход, по их словам, помогает находить краткие и локальные артефакты, которые пропускают однопроходные рассуждения.
Кому это важно
Тем, кто занимается проверкой подлинности видео и разработкой детекторов синтетического контента, а также исследователям агентных систем и обучения с подкреплением. Для них интересна сама схема с двумя временными масштабами обучения и подход, в котором набор экспертов не фиксирован, а дорабатывается по размеченным интервалам артефактов.
Как это применить
Пока это описание метода из аннотации препринта. В тексте не упомянут выпуск кода, моделей или данных, поэтому воспроизвести или внедрить систему по доступному материалу нельзя. Практическая польза сейчас, как идея архитектуры: разделить роли на координатора и инспекторов, обучать их с разной скоростью и привязывать вердикты к конкретным отрезкам видео и типам артефактов.
Можно ли доверять
Все цифры, заявления самих авторов, взятые из аннотации статьи; независимой проверки в материале нет. В тексте не названы отдельные бенчмарки, прежние детекторы и сильнейший из них, нет разбивки по бенчмаркам и отдельных значений для внутридоменных, внедоменных и агентных тестов. Неясно, означают ли 9,0% процентные пункты или относительный прирост. Имена авторов и их организации в тексте не указаны. 95,2%, среднее по нескольким бенчмаркам, а не результат на одном тесте.
Риски и подводные камни
В аннотации нет данных об ограничениях, случаях сбоя и доле ложных срабатываний, а для детектора они критичны: ошибочно признанное подделкой настоящее видео или пропущенная подделка стоят дорого. Не указаны число примеров в ForenCue-30K (30K входит в название, но явного количества нет), базовая модель и вычислительные затраты на обучение. Нет сведений о том, как система поведёт себя на видео от новых генераторов, которых не было в обучении, помимо упоминания внедоменных бенчмарков. Оценивать метод стоит по полному тексту статьи.