VSpark: спекулятивное декодирование ускоряет VLA-модели роботов в 1,28-2,10 раза
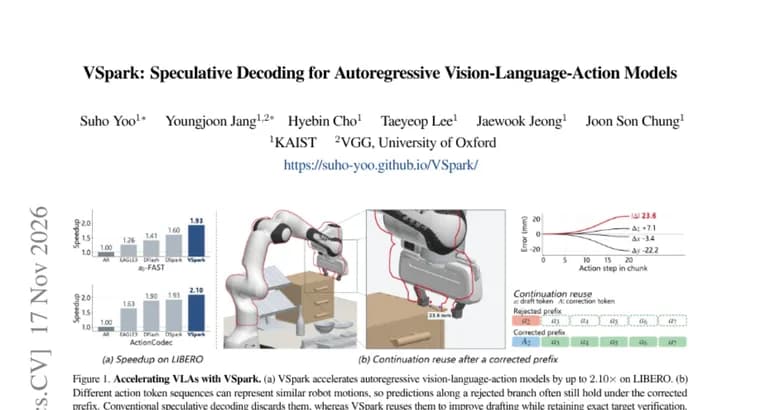
Статья посвящена ускорению авторегрессионных моделей «зрение, язык, действие» (VLA, vision-language-action). Такие модели управляют роботом, генерируя действия по одному токену за раз, и это медленно. Для ускорения используют спекулятивное декодирование: лёгкая черновая модель предлагает сразу несколько токенов, а сама VLA проверяет их за один проход и принимает только те, что совпадают с её собственными предсказаниями. Поэтому декодирование остаётся «lossless», то есть без потерь: результат совпадает с обычным.
Проблема, по словам авторов, в том, что в управлении роботом обычное спекулятивное декодирование даёт ограниченный выигрыш. Много разных токенов кодируют почти одно и то же движение, и черновик, близкий к правильному действию, всё равно отклоняется при проверке.
Чтобы это исправить, метод VSpark построен на трёх решениях. Первое: сбор прогонов (rollouts) с откалиброванным шумом в действиях, что показывает черновой модели более широкий набор состояний робота. Второе: выравнивание признаков (feature alignment), черновую модель обучают совпадать со скрытыми признаками VLA, а не только с её выходными токенами. Третье: повторное использование продолжений (continuation reuse), предсказания, которые VLA уже посчитала вдоль отклонённых черновиков, сохраняются как кандидаты для следующего шага проверки, а не выбрасываются.
Результат: на четырёх VLA с разными токенизаторами действий и на четырёх бенчмарках по манипуляции VSpark даёт ускорение в 1,28-2,10 раза, сохраняя декодирование VLA без потерь. Источник не уточняет, какому случаю соответствует нижняя и верхняя граница диапазона и усреднены ли эти значения.
Ключевые факты
- VSpark, метод спекулятивного декодирования для авторегрессионных VLA-моделей, которые генерируют действия робота по одному токену.
- Обычное спекулятивное декодирование в робототехнике ограничено: много разных токенов кодируют почти одинаковое движение, и близкий к верному черновик всё равно отклоняется.
- Метод опирается на три решения: прогоны с откалиброванным шумом в действиях, выравнивание признаков черновой модели со скрытыми признаками VLA и повторное использование предсказаний по отклонённым черновикам.
- Заявленное ускорение, от 1,28 до 2,10 раза на четырёх VLA с разными токенизаторами действий и четырёх бенчмарках по манипуляции.
- Декодирование остаётся без потерь: VLA принимает только те токены, которые совпадают с её собственными предсказаниями.
Почему это важно
Модели, которые выдают действия робота токен за токеном, упираются в скорость генерации. Спекулятивное декодирование хорошо известно как способ ускорения без потери результата, но, по словам авторов, в управлении роботом его эффект ограничен из-за того, что разные токены кодируют почти одно и то же движение. VSpark предлагает приспособить метод именно к этой особенности и заявляет ускорение в 1,28-2,10 раза.
Кому это важно
Исследователям и инженерам, которые работают с авторегрессионными VLA-моделями и токенизаторами действий, а также тем, кто занимается ускорением вывода (inference) в робототехнике. Для широкого читателя это скорее сигнал о направлении работ, чем готовый продукт.
Как это применить
Из доступного описания практическую инструкцию вывести нельзя. Идея в том, чтобы обучить лёгкую черновую модель на прогонах с калиброванным шумом в действиях, выровнять её со скрытыми признаками VLA и при проверке не выбрасывать уже посчитанные предсказания по отклонённым черновикам. Выпуск кода или моделей в источнике не упоминается.
Можно ли доверять
Это препринт, представленный на Hugging Face Papers; в доступном тексте нет имён авторов и организаций. Все цифры, заявления самих авторов. Источник не называет конкретные четыре VLA и четыре бенчмарка и не поясняет, к какому случаю относятся границы 1,28 и 2,10 раза и усреднён ли диапазон. Независимой проверки в материале нет.
Риски и подводные камни
Диапазон ускорения широкий, и без деталей неясно, какой результат типичен. В описании нет результатов на реальных роботах, доли успешно выполненных задач, задержек в миллисекундах и данных об оборудовании. Заявление о декодировании без потерь относится к совпадению с выходом самой VLA, а не к качеству управления в целом.