Video DeltaNet ускорил генерацию видео MiniMax H3 в 14,5 раза
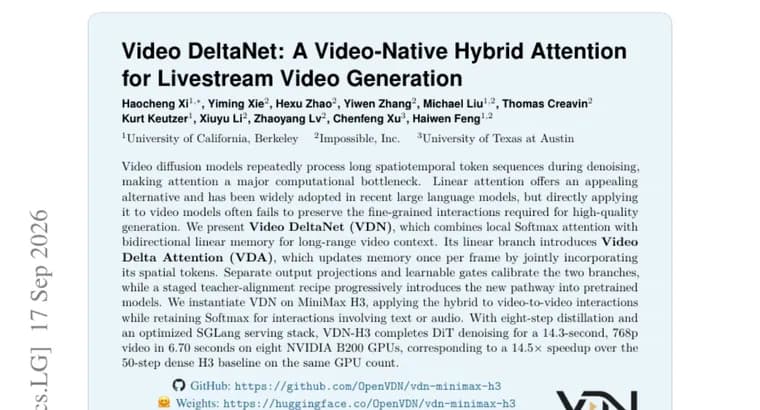
Видеодиффузионные модели на каждом шаге денойзинга (шумоподавления) заново обрабатывают длинные пространственно-временные последовательности токенов, и внимание (attention) становится главным вычислительным узким местом. Линейное внимание уже широко применяется в больших языковых моделях как более дешёвая альтернатива, но при прямом переносе на видео оно, по словам авторов, не сохраняет тонкие взаимодействия, нужные для качественной генерации.
Чтобы решить это, исследователи предложили Video DeltaNet (VDN), гибридный механизм, который совмещает локальное softmax-внимание с двунаправленной линейной памятью для учёта дальнего контекста видео. Линейная ветка называется Video Delta Attention (VDA): она обновляет память один раз за кадр, объединяя все пространственные токены этого кадра. Две ветки, softmax и линейную, калибруют раздельные проекции выхода и обучаемые гейты, а встроить новый путь в уже обученные модели позволяет поэтапная схема выравнивания с учителем (teacher-alignment), которая постепенно подмешивает линейную ветку в существующую архитектуру.
Авторы применили VDN к модели MiniMax H3, получив версию VDN-H3: гибридное внимание используется для взаимодействий видео-с-видео, а обычное softmax-внимание сохранено там, где видео взаимодействует с текстом или аудио. При восьми шагах дистилляции и на оптимизированном стеке инференса SGLang VDN-H3 полностью выполняет денойзинг DiT-модели для 14,3-секундного видео в разрешении 768p за 6,70 секунды на восьми GPU NVIDIA B200. Это в 14,5 раза быстрее, чем плотная (без гибридного внимания) версия H3 с 50 шагами денойзинга на том же числе GPU.
В самой публикации не указаны имена авторов и организаций, дата релиза, доступность кода или модели, а также сравнение с другими линейными или гибридными механизмами внимания для видео, только со стандартной плотной версией H3. Метрик качества генерации (например, FVD или оценки людьми) в тексте тоже нет: заявленный выигрыш, это выигрыш по скорости.
Ключевые факты
- Video DeltaNet (VDN) совмещает локальное softmax-внимание с двунаправленной линейной памятью (Video Delta Attention), которая обновляется раз в кадр по всем его пространственным токенам.
- Раздельные проекции выхода и обучаемые гейты калибруют обе ветки внимания, а поэтапная схема teacher-alignment встраивает линейную ветку в уже обученные модели.
- На MiniMax H3 гибрид применили только к взаимодействиям видео-с-видео, оставив softmax-внимание для текста и аудио.
- С восемью шагами дистилляции и на стеке SGLang VDN-H3 обрабатывает 14,3-секундное 768p-видео за 6,70 секунды на 8 GPU NVIDIA B200, против 50 шагов у плотной базовой версии.
- Итог, ускорение денойзинга в 14,5 раза на том же числе GPU; метрики качества генерации в публикации не приведены.
Почему это важно
Attention, главный вычислительный узел видеодиффузионных моделей: чем длиннее видео, тем дороже каждый шаг денойзинга. Линейное внимание уже снизило эту стоимость в языковых моделях, но при прямом переносе на видео теряло тонкие детали, важные для качества картинки. VDN предлагает не выбирать одно из двух, а совместить локальное softmax-внимание с линейной памятью для дальнего контекста, и на MiniMax H3 это дало 14,5-кратное ускорение денойзинга при том же числе GPU.
Кому это важно
Прежде всего командам, которые разрабатывают сервисы генерации и стриминга видео, включая живую (livestream) генерацию и сценарии видео-в-видео, где скорость денойзинга напрямую определяет задержку и стоимость GPU-инфраструктуры. Также, инженерам инференса больших диффузионных моделей, ищущим способы удешевить обслуживание без полной замены архитектуры внимания.
Как это применить
Публикация описывает метод и его применение к MiniMax H3 через восьмишаговую дистилляцию и стек инференса SGLang, но не сообщает ни о выпуске кода, ни о доступности модели, ни о сроках релиза, этой информации в тексте нет. Поэтому на практике пока можно опираться только на архитектурное описание: раздельные ветки softmax- и линейного внимания с калибрующими гейтами и поэтапное встраивание линейной ветки в уже обученную модель через teacher-alignment.
Можно ли доверять
Источник, карточка препринта на Hugging Face Papers с текстом аннотации; в самой аннотации не названы ни авторы, ни организации, представившие работу. Заявленное ускорение в 14,5 раза, конкретное измерение (6,70 секунды против времени 50-шаговой плотной версии на восьми GPU B200), но публикация сравнивает VDN-H3 только с этим одним базовым вариантом и не приводит метрик качества генерации (например, FVD или оценок людьми), заявлен именно выигрыш по скорости, а не подтверждённое сохранение качества.
Риски и подводные камни
Главный пробел, отсутствие метрик качества: ускорение в 14,5 раза измерено, а сохранилось ли при этом качество генерации по сравнению с полной 50-шаговой моделью, по тексту публикации проверить нельзя. Также нет сравнения с другими линейными или гибридными механизмами внимания для видео, кроме дефолтной плотной модели, и неизвестно, насколько метод переносится на модели, отличные от MiniMax H3.