VibePrevisBench: новый тест кодинг-агентов на 4D-сценах в Blender
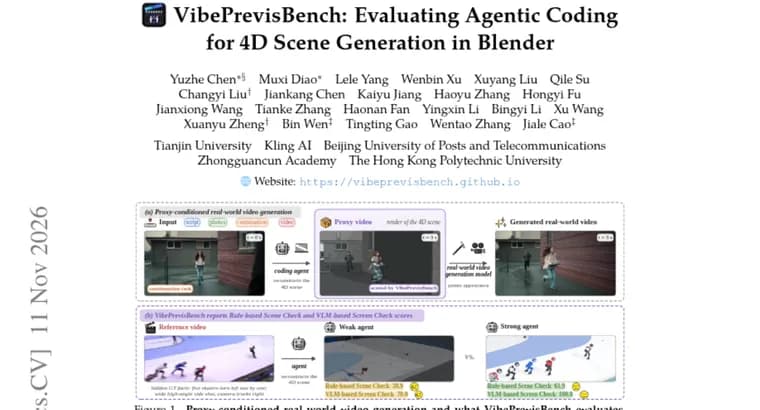
Исследователи предложили VibePrevisBench, бенчмарк для кодинг-агентов, которые строят 4D-сцены (трёхмерное пространство плюс время) в Blender. Исходная идея такова: модели генерации реалистичного видео можно управлять, подав им на вход отрендеренное прокси-видео в стиле graybox (упрощённый серый макет), которое фиксирует расположение объектов, движение и камеру. Кодинг-агенты умеют собирать такие видео, восстанавливая 4D-сцену в Blender, но, по утверждению авторов, ни один существующий бенчмарк не проверяет одновременно и сами видео, и длинные многоплановые сцены (multi-shot), на которых они построены.
Задача в VibePrevisBench, реконструкция 4D-сцены: агент получает задание (бриф), превращает его в исполняемую 4D-сцену и рендерит прокси-видео. В бенчмарке 242 задачи, и они делятся на четыре вида входных данных: сценарии, фотографии, продолжения и референсные видео.
Каждый результат оценивается по двум направлениям. Первое, Scene Check, проверка по правилам: она заново запускает код агента и сравнивает экспортированную 4D-сцену со скрытыми эталонными фактами по девяти измерениям. Второе, Screen Check на основе VLM (визуально-языковой модели): модель-судья отвечает, можно ли те факты, которые прошли первую проверку, распознать в прокси-видео.
Авторы проанализировали результаты и траектории работы 11 передовых кодинг-агентов и выделили три наблюдения. Первое: агентов разделяет мультимодальное понимание, особенно понимание пространства и движения камеры. Второе: все агенты, судя по всему, уже освоили базовую работу с камерой и постановку кадра, но проваливают сложные требования. Третье: агенты просматривают собственные рендеры, однако не исправляют найденные ошибки.
Из этого авторы делают вывод: агентам нужно лучше визуально понимать пространство и камеру, явно проверять сложные требования и сверять рендеры с заданием пункт за пунктом.
Ключевые факты
- VibePrevisBench, бенчмарк, где кодинг-агент превращает задание в исполняемую 4D-сцену в Blender и рендерит её прокси-видео.
- В бенчмарке 242 задачи с четырьмя видами входных данных: сценарии, фотографии, продолжения и референсные видео.
- Оценка двойная: Scene Check по правилам (сравнение сцены со скрытыми эталонными фактами по девяти измерениям) и Screen Check через VLM-судью (видны ли эти факты в видео).
- Проанализированы результаты и траектории 11 передовых кодинг-агентов: их разделяет понимание пространства и движения камеры.
- Базовую камеру и постановку кадра агенты, судя по всему, уже осваивают, но проваливают сложные требования и не исправляют собственные ошибки после просмотра рендеров.
Почему это важно
Прокси-видео в стиле graybox, по словам авторов, позволяет управлять моделями генерации реалистичного видео: оно фиксирует расположение объектов, движение и камеру. Кодинг-агенты могут собирать такие видео, строя сцену в Blender кодом. По утверждению авторов, до сих пор не было бенчмарка, проверяющего и видео, и длинные многоплановые сцены, на которых они держатся. VibePrevisBench закрывает этот пробел и показывает, где именно агенты ошибаются: в пространстве, камере и самопроверке.
Кому это важно
Исследователям и разработчикам кодинг-агентов, особенно мультимодальных: бенчмарк даёт способ измерять работу с 3D-сценой и камерой, а не только качество кода. Также он будет полезен тем, кто строит конвейеры «сценарий или референс, затем макет сцены, затем видео»: из результатов видно, чего ждать от агентов уже сейчас.
Как это применить
Из выводов авторов следуют три практических направления для агентов: улучшать визуальное понимание пространства и камеры, добавлять явные проверки для сложных требований, сверять рендеры с заданием по пунктам. Для оценки собственного агента можно использовать двухступенчатую схему бенчмарка: сначала проверка экспортированной сцены по эталонным фактам, затем проверка, видны ли эти факты в видео. Сведений о выпуске кода, данных или лицензии в аннотации нет.
Можно ли доверять
Это аннотация научной статьи, и выводы в ней принадлежат самим авторам бенчмарка. В тексте не названы авторы и организации, не названы 11 протестированных агентов и не приведены численные результаты, поэтому проверить силу выводов по одной аннотации нельзя. Второе наблюдение сформулировано осторожно («судя по всему»). Проверка Screen Check опирается на VLM-судью, а модель судьи в тексте не указана.
Риски и подводные камни
Бенчмарк привязан к конкретной задаче и инструменту (Blender, прокси-видео), так что выводы не обязательно переносятся на другие виды кодинга. Девять измерений Scene Check в аннотации не перечислены, поэтому неясно, что именно считается ошибкой. Оценка Screen Check зависит от VLM-судьи, у которого могут быть собственные ошибки распознавания. Наконец, без чисел и названий агентов нельзя сравнить системы между собой.
«Агентам нужно лучше визуально понимать пространство и камеру, явно проверять сложные требования и поэлементно сверять рендеры с заданием.»
— авторы статьи VibePrevisBench