Ускорение обучения диффузионных трансформеров связали с гейтом AdaLN-Zero
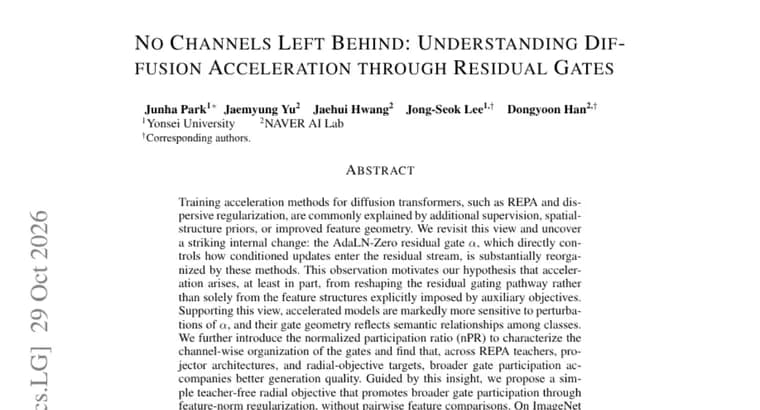
Методы ускорения обучения диффузионных трансформеров, такие как REPA и дисперсионная регуляризация (dispersive regularization), обычно объясняют дополнительным обучающим сигналом, априорными знаниями о пространственной структуре или улучшенной геометрией признаков. Авторы статьи пересматривают это объяснение и сообщают о заметном внутреннем изменении: остаточный гейт α в блоках AdaLN-Zero, который напрямую управляет тем, как обновления, зависящие от условия, попадают в остаточный поток, существенно перестраивается этими методами.
Отсюда гипотеза авторов: ускорение возникает, по крайней мере отчасти, из-за изменения пути остаточного гейтирования, а не только из-за структур признаков, которые явно навязываются вспомогательными целями обучения. В подтверждение авторы приводят два наблюдения: ускоренные модели заметно сильнее реагируют на возмущения α, а геометрия их гейтов отражает семантические связи между классами.
Для описания канальной организации гейтов вводится нормированный коэффициент участия (normalized participation ratio, nPR). По утверждению авторов, при разных учителях REPA, разных архитектурах проектора и разных целях радиальной функции более широкое участие каналов гейта сопровождает лучшее качество генерации. Это корреляция, причинность авторы в аннотации не заявляют.
Опираясь на это, авторы предлагают простую радиальную цель обучения без модели-учителя. Она поощряет более широкое участие гейта через регуляризацию норм признаков и не требует попарных сравнений признаков. На ImageNet 256×256 с моделью SiT-B/2 метод, по заявлению авторов, улучшает FID по сравнению с dispersive loss и одновременно повышает среднее участие гейта по временным шагам и классам. Авторы считают это дополнительным подтверждением связи между организацией гейта и ускорением обучения и называют перестройку остаточного гейта измеримой осью ускорения обучения диффузионных моделей.
Ключевые факты
- Методы ускорения вроде REPA и дисперсионной регуляризации, по данным авторов, существенно перестраивают остаточный гейт α в AdaLN-Zero.
- Ускоренные модели заметно чувствительнее к возмущениям α, а геометрия их гейтов отражает семантические связи между классами.
- Введён нормированный коэффициент участия (nPR): более широкое участие каналов гейта сопровождает лучшее качество генерации.
- Предложена простая радиальная цель без модели-учителя: регуляризация норм признаков, без попарных сравнений признаков.
- На ImageNet 256×256 с SiT-B/2 метод улучшает FID относительно dispersive loss и повышает среднее участие гейта по временным шагам и классам.
Почему это важно
Обучение диффузионных трансформеров дорого, и методы ускорения вроде REPA стали обычным приёмом. Статья предлагает другое объяснение их работы: не только вспомогательный сигнал и структура признаков, но и перестройка остаточного гейта α. Если гипотеза подтвердится, у исследователей появится измеримая внутренняя величина, по которой можно сравнивать и проектировать методы ускорения.
Кому это важно
Исследователям диффузионных моделей и трансформеров для генерации изображений, которые занимаются ускорением обучения, регуляризацией и интерпретируемостью внутренних механизмов (в частности, условной модуляции AdaLN-Zero). Для практиков, не работающих с обучением таких моделей, работа пока имеет ограниченную прикладную ценность.
Как это применить
Идею можно использовать как диагностику: измерять nPR гейтов у собственных моделей и сравнивать с качеством генерации. Предложенная радиальная цель обучения не требует модели-учителя и попарных сравнений признаков, поэтому в принципе может заменять dispersive loss в похожих схемах обучения. Определение и формула nPR в аннотации не приведены, поэтому для воспроизведения нужен полный текст статьи.
Можно ли доверять
Это препринт, представленный в виде аннотации на Hugging Face Papers; все утверждения принадлежат авторам. В аннотации нет значений FID, базовых цифр и размера улучшения, не названы авторы и организации, не указан коэффициент ускорения обучения. Результаты заявлены только для ImageNet 256×256 с SiT-B/2. Связь между широким участием гейта и качеством подана как корреляция, а механизм ускорения, как гипотеза («по крайней мере отчасти»).
Риски и подводные камни
Корреляция между участием гейта и качеством не доказывает причинность. Выводы получены на одной модели и одном наборе данных (SiT-B/2, ImageNet 256×256), поэтому переносимость на другие размеры моделей и разрешения неизвестна. Без числовых результатов трудно оценить, насколько велик выигрыш по FID относительно dispersive loss и стоит ли он усилий по внедрению.
«Наши результаты выделяют перестройку остаточного гейта как измеримую ось ускорения обучения диффузионных моделей и предлагают простое направление для дальнейшего ускорения.»
— Из аннотации статьи