Исследование: хранят ли визуальные модели устойчивое пространственное состояние
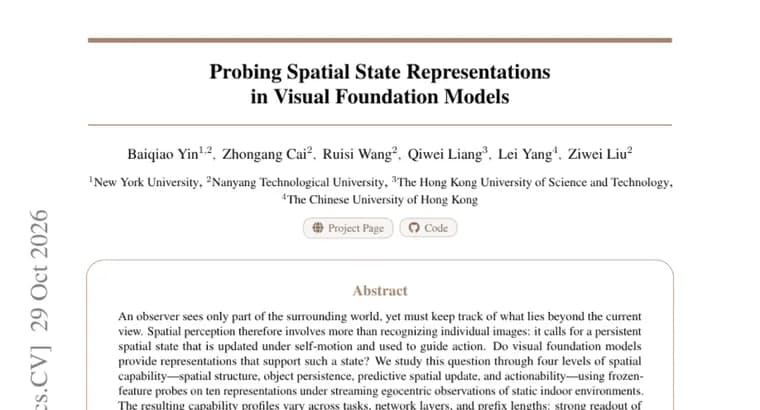
Наблюдатель видит лишь часть окружающего мира, но должен отслеживать то, что находится за пределами текущего обзора. Поэтому, как пишут авторы, пространственное восприятие, это не только распознавание отдельных изображений: нужно устойчивое пространственное состояние, которое обновляется при собственном движении и используется для управления действиями. Вопрос работы: дают ли визуальные фундаментальные модели представления, способные поддерживать такое состояние?
Для ответа авторы выделили четыре уровня пространственных способностей: пространственная структура, устойчивость объектов (object persistence, объект не «исчезает», когда выходит из кадра), предсказательное обновление пространства и применимость для действий (actionability). Они применили зонды на замороженных признаках (frozen-feature probes, небольшие читающие модули поверх неизменённых признаков) к десяти представлениям. Наблюдения, потоковые, от первого лица (egocentric), в статичных помещениях. Какие именно десять представлений взяты, в тексте аннотации не названо.
Результаты. Профили способностей различаются в зависимости от задачи, слоя сети и длины префикса (длины просмотренной части потока). Уверенное считывание видимой сцены не гарантирует ни точной устойчивости объектов, ни извлечения будущих признаков. Контрольные эксперименты с подобранными условиями (matched controls) позволяют отделить точность считывания от опоры на визуальную историю и движение.
Собственное предсказание будущего сохраняет восстановимую пространственную структуру, но «читатель» пространства, обученный на реальных признаках, не переносится на предсказанные признаки без изменений. Наконец, выбор кандидата с учётом цели не доказывает надёжной полезности для непрерывных действий: предсказанные действия реагируют на смену цели, но подстановка правильной цели не гарантированно улучшает продвижение.
Между уровнями есть зависимости: устойчивость объектов и применимость для действий опираются на считывание позы камеры, а предсказание признаков, на считывание видимой сцены. Общий итог авторов: пространственные представления стоит оценивать не только по тому, что из них можно декодировать, но и по тому, сохраняется ли эта информация за пределами наблюдения, обновляется ли предсказательно и используется ли для целенаправленных действий.
Ключевые факты
- Изучены десять представлений визуальных фундаментальных моделей на четырёх уровнях: пространственная структура, устойчивость объектов, предсказательное обновление, применимость для действий.
- Метод: зонды на замороженных признаках, потоковые наблюдения от первого лица в статичных помещениях.
- Хорошее считывание видимой сцены не гарантирует точной устойчивости объектов и извлечения будущих признаков.
- «Читатель» пространства, обученный на реальных признаках, не переносится на предсказанные признаки без изменений.
- Предсказанные действия реагируют на смену цели, но правильная цель не гарантированно улучшает продвижение.
Почему это важно
Работа ставит под сомнение привычное мерило качества пространственных представлений, то, что из них удаётся декодировать в текущем кадре. Авторы показывают, что для настоящего пространственного восприятия этого мало: нужно устойчивое состояние, обновляемое при движении и пригодное для действий. Это сдвигает акцент оценки с «что видно сейчас» на «что удерживается, предсказывается и используется».
Кому это важно
Исследователям визуальных фундаментальных моделей и пространственного восприятия, а также тем, кто строит системы навигации и управления действиями на основе замороженных признаков и хочет понимать, какие способности эти признаки реально поддерживают.
Как это применить
Из аннотации следует практический ориентир для оценки: помимо точности считывания видимой сцены проверять устойчивость объектов вне кадра, качество предсказания будущих признаков и пользу для целенаправленных действий, а также сверять результаты по слоям сети и длине префикса. Код, наборы данных и релиз в тексте не упомянуты.
Можно ли доверять
Это препринт, доступный в виде аннотации. Названия десяти представлений, численные результаты, наборы данных и сведения об авторах в тексте не приведены, поэтому проверить силу выводов по одной аннотации нельзя. Утверждения носят диагностический характер и принадлежат авторам работы.
Риски и подводные камни
Исследование охватывает только статичные помещения при потоковых наблюдениях от первого лица; о динамичных или уличных сценах и реальных роботах в тексте ничего не сказано, так что переносить выводы за эти рамки нельзя. Без чисел и названий моделей трудно понять масштаб обнаруженных разрывов.