TTR-Compressor: сжатие последовательностей через регрессию на лету сокращает визуальные токены на 55,6%
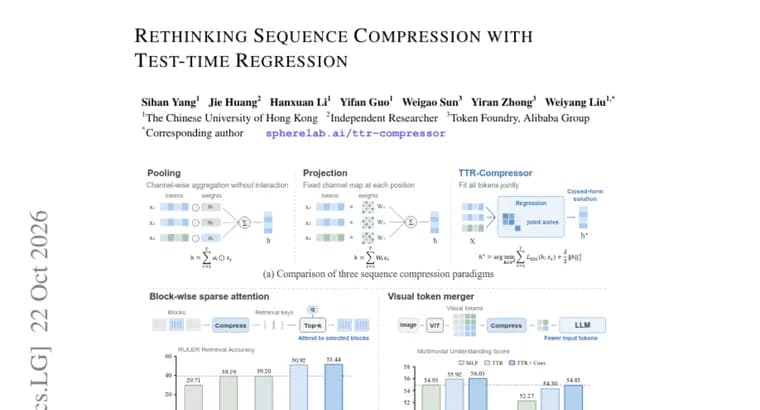
Авторы препринта, опубликованного на Hugging Face Papers, отмечают, что сжатие последовательностей, базовая операция и критическое информационное «узкое место» в эффективных языковых и мультимодальных моделях, а распространённые подходы на основе пулинга (усреднения по группам токенов) или обучаемых проекций по-прежнему работают недостаточно хорошо.
Идея работы, взглянуть на сжатие через призму регрессии на этапе вывода (test-time regression). Входные токены задают задачу регрессии, а подогнанные коэффициенты и образуют сжатое представление. Сама регрессионная задача обучается сквозным образом через обратное распространение ошибки, при этом коэффициенты вычисляются эффективно, в замкнутой форме, прямо во время прямого прохода. Так получается TTR-Compressor, который авторы называют универсальной альтернативой привычному сжатию на основе пулинга и проекций.
Метод проверен в двух ролях. Первая, компрессор для блочного разреженного внимания (block-wise sparse attention): по утверждению авторов, на бенчмарке RULER он «с большим отрывом» превосходит компрессоры на основе внимания. Вторая, слияние визуальных токенов (visual token merger) в мультимодальных больших языковых моделях: здесь TTR-Compressor, как сообщается, стабильно превосходит стандартный MLP-слиятель и достигает его качества, используя на 55,6% меньше визуальных токенов (относительно числа токенов MLP-слиятеля).
Вывод авторов: результаты показывают, что регрессия на этапе вывода, эффективный базовый приём для сжатия последовательностей в эффективных языковых и мультимодальных моделях.
Ключевые факты
- TTR-Compressor рассматривает входные токены как задачу регрессии, а подогнанные коэффициенты используются как сжатое представление.
- Регрессия обучается сквозным образом через обратное распространение, а коэффициенты считаются в замкнутой форме во время прямого прохода.
- На блочном разреженном внимании метод, по заявлению авторов, значительно улучшает результат на RULER относительно компрессоров на основе внимания.
- При слиянии визуальных токенов в мультимодальных моделях он стабильно превосходит стандартный MLP-слиятель и догоняет его качество используя на 55,6% меньше визуальных токенов.
Почему это важно
Сжатие последовательностей, одно из узких мест эффективных языковых и мультимодальных моделей: чем меньше токенов нужно обрабатывать без потери информации, тем дешевле работа. Авторы утверждают, что пулинг и обучаемые проекции здесь уступают, и предлагают другой взгляд, через регрессию на этапе вывода. Заявленное сокращение визуальных токенов на 55,6% при том же качестве, что у стандартного MLP-слиятеля, указывает на практический потенциал, но пока это лишь утверждение из аннотации.
Кому это важно
Исследователям эффективных архитектур и разреженного внимания, разработчикам мультимодальных моделей, где визуальные токены занимают заметную часть контекста, а также тем, кто работает с длинным контекстом и оценивает его на RULER.
Как это применить
По имеющемуся тексту (только аннотация) практических инструкций нет: сведений о выпуске кода или моделей в нём нет. Идея, которую можно взять на заметку: заменить пулинг или проекцию в блоке сжатия на слой, где коэффициенты регрессии считаются в замкнутой форме, а параметры задачи обучаются сквозным образом. Для оценки стоит дождаться полного текста статьи.
Можно ли доверять
Все утверждения исходят от самих авторов и приведены в аннотации. Абсолютные значения RULER, размер «большого отрыва», названия и размеры моделей, наборы данных для мультимодальной оценки не указаны. Цифра 55,6% дана относительно числа визуальных токенов стандартного MLP-слиятеля, базовое число токенов не приводится. Независимой проверки в тексте нет.
Риски и подводные камни
Оценка опирается только на аннотацию: без подробностей экспериментов нельзя судить об устойчивости результатов, о выигрыше по вычислениям, задержке или памяти, в тексте они не названы. Формулировки «с большим отрывом» и «стабильно» качественные, и их надо проверять по таблицам полной статьи.