AgentVQA: новый бенчмарк показал, что лучшая из 22 моделей набирает лишь 58,5%
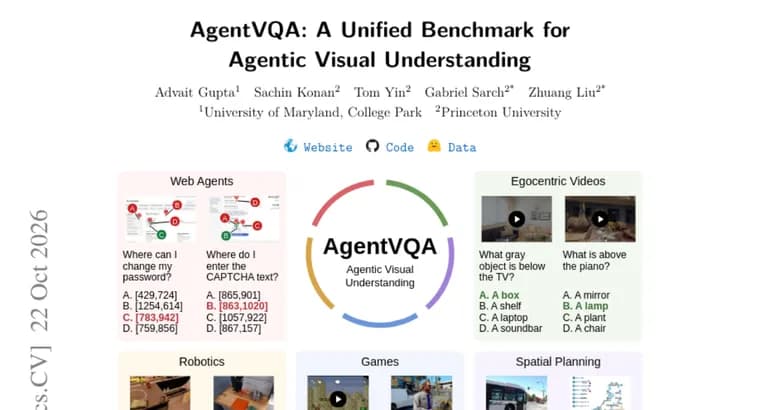
Авторы статьи на Hugging Face Papers представили AgentVQA, офлайн-бенчмарк для оценки визуально-языковых моделей (VLM) в реалистичных агентных сценариях. Исходная проблема: возможности таких моделей в агентных контекстах изучены плохо. Онлайн-оценка в симуляторах и реальных средах нужна для измерения интерактивной работы агентов, но она дорогая и плохо масштабируется. Офлайн-бенчмарки на основе визуальных вопросов и ответов (VQA) позволили бы сравнивать модели быстрее и надёжнее, однако, по оценке авторов, существующие наборы ограничены и разрознены.
AgentVQA охватывает пять агентных областей: веб-агенты, робототехника, видео от первого лица (egocentric), игры и пространственное планирование. Набор собран вручную: авторы отобрали 1000 сложных примеров реальных агентов из 23 исходных датасетов и адаптировали их для надёжной офлайн-оценки. По утверждению авторов, бенчмарк сохраняет реалистичные сценарии из интерактивных сред, а рейтинги моделей на нём совпадают с рейтингами соответствующих онлайн-оценок.
Среди 22 протестированных моделей лучшая показала всего 58,5% точности. Межобластной анализ ошибок, по словам авторов, показывает: ошибки вызваны прежде всего неспособностью модели привязать происходящее к изображению и поддерживать точное представление о текущем и меняющемся визуальном состоянии. Это включает поиск нужных элементов интерфейса, интерпретацию движения, отслеживание изменений состояния во времени и определение трёхмерных пространственных отношений. Причиной при этом служат не неверное понимание задачи и не последующие логические рассуждения.
Ключевые факты
- AgentVQA, офлайн-бенчмарк для визуально-языковых моделей в агентных сценариях: 1000 сложных примеров, отобранных вручную из 23 исходных датасетов.
- Пять областей: веб-агенты, робототехника, видео от первого лица, игры и пространственное планирование.
- Из 22 оценённых моделей лучшая достигла лишь 58,5% точности.
- По утверждению авторов, рейтинги моделей на AgentVQA совпадают с рейтингами соответствующих онлайн-оценок.
- Основной источник ошибок, сбои в привязке к визуальному состоянию и его отслеживании (элементы интерфейса, движение, смена состояния, 3D-отношения), а не непонимание задачи или логика.
Почему это важно
Онлайн-проверка агентов в симуляторах и реальных средах дорога и плохо масштабируется, а существующие офлайн-наборы, по оценке авторов, ограничены и разрознены. AgentVQA предлагает единый дешёвый способ сравнивать модели сразу в пяти агентных областях. Результат в 58,5% у лучшей из 22 моделей показывает, что до надёжного визуального понимания в агентных задачах ещё далеко.
Кому это важно
Исследователям и разработчикам визуально-языковых моделей и агентов: веб-агентов, роботов, игровых и навигационных систем. Также командам, которым нужно быстро сравнивать модели без дорогих онлайн-прогонов.
Как это применить
Бенчмарк можно рассматривать как офлайн-замену или дополнение к онлайн-тестам при сравнении моделей для агентных задач. Вывод об ошибках подсказывает, куда направлять усилия: на точную привязку к элементам интерфейса, понимание движения, отслеживание изменений состояния и пространственное мышление, а не на улучшение логических рассуждений.
Можно ли доверять
Все сведения основаны на аннотации статьи, то есть на заявлениях самих авторов. Утверждение о совпадении рейтингов с онлайн-оценками приводится без числовой меры согласия. Не названы конкретные модели, включая лучшую с 58,5%, не приведены результаты по областям, поэтому проверить выводы по аннотации нельзя.
Риски и подводные камни
Выборка из 1000 примеров отобрана вручную, а значит, на результат может влиять выбор составителей. Офлайн-оценка по определению не заменяет проверку агента в интерактивной среде, даже если рейтинги, по словам авторов, совпадают. Вывод о причинах ошибок получен авторами в их собственном анализе и требует независимой проверки.