TrustReviewer: авторы нашли коллапс оценок при обучении ИИ на ИИ-рецензиях
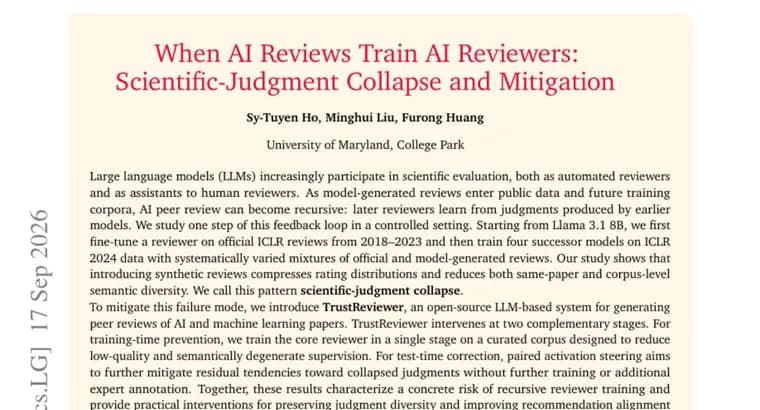
Языковые модели всё чаще участвуют в научном рецензировании, как самостоятельные автоматические рецензенты и как помощники людей-рецензентов. Рецензии, написанные моделями, попадают в открытые данные и в будущие обучающие корпуса, поэтому рецензирование с помощью ИИ рискует стать рекурсивным: следующие поколения моделей-рецензентов учатся на суждениях, которые составили более ранние модели. Исследователи изучили один шаг этой обратной связи в контролируемом эксперименте.
За основу взяли модель Llama 3.1 с 8 млрд параметров: сначала на её базе дообучили рецензента на настоящих официальных рецензиях конференции ICLR за 2018, 2023 годы, а затем обучили четыре модели-«наследника» на рецензиях ICLR 2024 года с разными пропорциями настоящих (официальных) и синтетических (сгенерированных моделями) рецензий.
Результат: добавление синтетических рецензий в обучающие данные сжимает распределение оценок и снижает семантическое разнообразие суждений, как в пределах рецензий на одну и ту же статью, так и на уровне всего корпуса рецензий. Авторы называют это явление «коллапсом научного суждения» (scientific-judgment collapse).
Чтобы смягчить эффект, авторы предложили TrustReviewer, систему с открытым кодом на основе ИИ для генерации рецензий статей по ИИ и машинному обучению. Она работает в две стадии: на этапе обучения рецензента его обучают за один проход на специально отобранном корпусе, из которого убраны низкокачественные и семантически «выродившиеся» примеры рецензий; на этапе применения используется техника «парного управления активациями» (paired activation steering), которая должна дополнительно снижать остаточную склонность модели к «схлопнутым» суждениям, без дополнительного обучения и без привлечения экспертной разметки.
Ключевые факты
- Исследователи дообучили ИИ-рецензента на базе Llama 3.1 (8 млрд параметров) на настоящих рецензиях ICLR 2018, 2023, затем обучили четыре модели-«наследника» на рецензиях ICLR 2024 с разной долей синтетических (ИИ-сгенерированных) рецензий.
- Добавление синтетических рецензий в обучение сжимает распределение оценок и снижает семантическое разнообразие суждений, и на уровне одной статьи, и на уровне всего корпуса; авторы называют это «коллапсом научного суждения».
- Для смягчения предложена открытая система TrustReviewer с двумя механизмами: обучение рецензента на очищенном от низкокачественных примеров корпусе и техника «парного управления активациями» на этапе применения.
- Работа указывает на риск рекурсивного обучения: если рецензии, написанные моделями, всё больше попадают в будущие обучающие данные, разнообразие научных суждений может продолжать сужаться.
- В источнике нет числовых показателей величины эффекта и эффективности TrustReviewer, а также нет полного списка авторов, даты релиза, лицензии и места публикации кода.
Почему это важно
ИИ всё активнее участвует в рецензировании научных статей, как автоматический рецензент и как помощник людей на конференциях вроде ICLR. Работа показывает конкретный механизм, из-за которого качество и разнообразие таких суждений могут деградировать от поколения к поколению: если модели-рецензенты обучаются на рецензиях, написанных предыдущими моделями, оценки статей становятся менее разнообразными и более «однотипными».
Кому это важно
Организаторам и программным комитетам ML-конференций, которые используют или рассматривают ИИ-инструменты для рецензирования; разработчикам систем автоматического рецензирования; исследователям, чьи статьи проходят через рецензирование с участием ИИ.
Как это применить
TrustReviewer выпущен с открытым кодом, и авторы описывают его подход как шаблон для внедрения: очищать обучающий корпус рецензента от низкокачественных и «выродившихся» синтетических рецензий на этапе обучения и дополнительно применять «парное управление активациями» на этапе генерации рецензии, чтобы снижать склонность к схлопнутым, однотипным оценкам.
Можно ли доверять
Эксперимент контролируемый, но ограничен по масштабу: одна базовая модель (Llama 3.1 8B) и данные одной конференции. В самом источнике не указана числовая величина сжатия оценок и разнообразия и не приведены количественные результаты проверки эффективности TrustReviewer. В аннотации также не назван полный авторский коллектив, организации, дата релиза, лицензия или место публикации кода TrustReviewer. Это делает вывод скорее ранним исследовательским сигналом, чем проверенным на практике решением.
Риски и подводные камни
Если рецензии, написанные моделями, продолжат попадать в открытые данные и будущие обучающие корпуса, эффект однородности суждений может накапливаться не только в ICLR, но и в рецензировании шире. Эффективность самого TrustReviewer пока не подтверждена количественно, а сроки релиза, лицензия и код в источнике не раскрыты, значит, полагаться на инструмент как на готовое решение преждевременно.
«Наше исследование показывает, что внедрение синтетических рецензий сжимает распределение оценок и снижает семантическое разнообразие как в пределах рецензий на одну статью, так и на уровне всего корпуса.»
— авторы исследования