StyleStream 2.0 меняет голос в потоке с задержкой 520 мс и по текстовым подсказкам
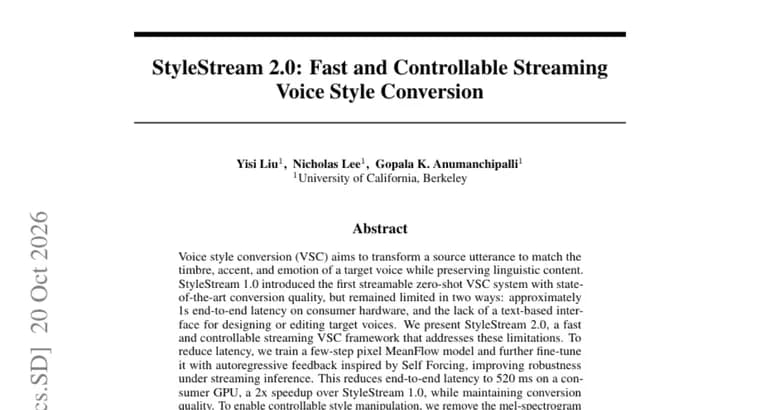
Конверсия стиля голоса (voice style conversion, VSC) переделывает исходную речь так, чтобы она звучала с тембром, акцентом и эмоцией целевого голоса, сохраняя при этом содержание сказанного. Первая версия, StyleStream 1.0, по словам авторов, была первой потоковой системой такого рода с нулевой подгонкой под конкретный голос (zero-shot) и передовым качеством конверсии. Но у неё было два ограничения: сквозная задержка около 1 секунды на потребительском оборудовании и отсутствие текстового интерфейса для создания или правки целевых голосов.
В StyleStream 2.0 обе проблемы решают. Чтобы снизить задержку, авторы обучили малошаговую модель pixel MeanFlow и дообучили её с авторегрессионной обратной связью по мотивам метода Self Forcing, что повышает устойчивость при потоковом выводе. В итоге сквозная задержка на потребительской видеокарте составляет 520 мс, то есть вдвое меньше, чем у версии 1.0, а качество конверсии, по утверждению авторов, сохраняется.
Для управляемости стиля из модели убрали контекст в виде мел-спектрограммы: информация о целевом стиле теперь передаётся через компактное эмбеддинговое представление стиля (style embedding). В пространстве этих эмбеддингов обучена единая модель flow matching с текстовым условием. Она поддерживает два режима: текстовое проектирование голоса (voice design), когда запрос на естественном языке превращается в стиль голоса, и правку голоса по инструкции (voice editing), когда меняется один заданный атрибут исходной речи, а остальное сохраняется.
По результатам экспериментов, StyleStream 2.0 показывает самое высокое соответствие целевому стилю в трёх задачах: конверсии стиля, проектировании и правке голоса. По разборчивости речи и сохранению неизменяемых атрибутов система остаётся конкурентоспособной, то есть лучшей по этим показателям её не называют.
Ключевые факты
- StyleStream 2.0 снижает сквозную задержку потоковой конверсии стиля голоса до 520 мс на потребительской видеокарте, вдвое быстрее, чем StyleStream 1.0 (около 1 с).
- Ускорение достигнуто за счёт малошаговой модели pixel MeanFlow, дообученной с авторегрессионной обратной связью в духе Self Forcing; качество конверсии, как утверждают авторы, сохраняется.
- Контекст мел-спектрограммы заменён компактным эмбеддингом стиля, а поверх него обучена единая текстовая модель flow matching.
- Новые возможности: проектирование голоса по описанию на естественном языке и правка одного атрибута голоса по инструкции.
- Система заявляет лучшее соответствие целевому стилю в трёх задачах, а по разборчивости и сохранению неизменённых атрибутов остаётся лишь конкурентоспособной.
Почему это важно
Для живого общения голосом, например в звонках и стриминге, главное ограничение конверсии голоса, задержка. Версия 1.0 давала около секунды, версия 2.0, 520 мс на потребительской видеокарте, то есть вдвое меньше. Вторая новость, управляемость: голос теперь можно описать словами или поправить одним атрибутом по инструкции, не подбирая образец целевой речи.
Кому это важно
Исследователям синтеза и преобразования речи, разработчикам голосовых интерфейсов и систем потоковой обработки звука. Тем, кто следит за применением методов flow matching и MeanFlow в аудио, интересен приём с дообучением на авторегрессионной обратной связи в духе Self Forcing.
Как это применить
В описании не упомянуты код, веса модели, демо или лицензия, поэтому сразу воспользоваться системой нельзя. Практическая польза пока в идеях: малошаговая модель с дообучением под потоковый режим, замена мел-спектрограммного контекста компактным эмбеддингом стиля и единая текстовая модель в пространстве эмбеддингов для проектирования и правки голоса.
Можно ли доверять
Все утверждения взяты из аннотации статьи и принадлежат самим авторам. Названий наборов данных, метрик, числовых значений и систем для сравнения в тексте нет, поэтому превосходство по соответствию стилю проверить по нему нельзя. Не указано, средняя ли задержка 520 мс, медианная или наихудшая, и какая именно видеокарта использовалась. Имена авторов и организации в тексте не приведены.
Риски и подводные камни
Заявленное сохранение качества при ускорении и лидерство по соответствию стилю пока не подкреплены в доступном тексте цифрами. По разборчивости и сохранению неизменяемых атрибутов система лишь конкурентоспособна, то есть не обязательно лучшая. Технологии преобразования голоса в целом допускают злоупотребления, но в источнике об этом не говорится.