SLA: модель для роботов на базе pi05 учат понимать 3D-пространство
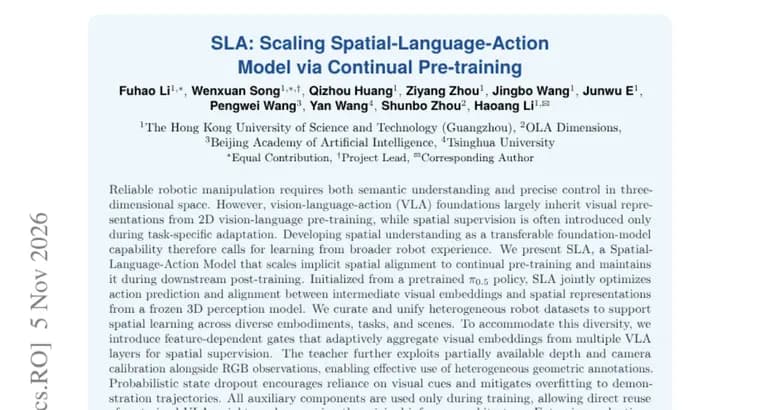
В статье, размещённой в разделе Hugging Face Papers, представлена модель SLA (Spatial-Language-Action Model, «пространственно-языково-действенная» модель). Исходная проблема, по словам авторов: для надёжного манипулирования роботу нужны и смысловое понимание сцены, и точное управление в трёхмерном пространстве. Но базовые модели «зрение, язык, действие» (VLA) в основном наследуют зрительные представления от двумерного предобучения на изображениях и тексте, а пространственный сигнал обычно добавляют лишь на этапе адаптации к конкретной задаче. Поэтому, считают авторы, пространственное понимание как переносимую способность базовой модели нужно развивать на более широком опыте роботов.
SLA стартует с уже предобученной политики pi05 и в ходе непрерывного дообучения (continual pre-training) одновременно оптимизирует две вещи: предсказание действий и согласование промежуточных зрительных эмбеддингов (векторных представлений) с пространственными представлениями из замороженной модели 3D-восприятия. Такое неявное пространственное выравнивание авторы масштабируют на этап непрерывного предобучения и сохраняют на последующем дообучении под конкретные задачи.
Для этого авторы собрали и унифицировали разнородные наборы данных о роботах, чтобы обучать пространственному пониманию на разных типах роботов, задачах и сценах. Чтобы справляться с таким разнообразием, они добавили зависящие от признаков гейты (управляющие вентили), которые адаптивно объединяют зрительные эмбеддинги из нескольких слоёв VLA для пространственного обучения. «Учитель» (3D-модель) дополнительно использует частично доступные данные о глубине и калибровке камер вместе с RGB-кадрами, что позволяет применять неоднородные геометрические аннотации. Вероятностное выключение входного состояния робота (state dropout) заставляет модель сильнее опираться на зрение и снижает переобучение на демонстрационные траектории.
Все вспомогательные компоненты работают только во время обучения. Поэтому можно напрямую переиспользовать веса предобученной VLA, а архитектура на этапе вывода (инференса) остаётся прежней.
Ключевые факты
- SLA, модель «зрение, язык, действие» для роботов, инициализированная из предобученной политики pi05.
- Во время обучения она совместно оптимизирует предсказание действий и согласование промежуточных зрительных эмбеддингов с представлениями замороженной 3D-модели восприятия.
- Для разнородных данных авторы вводят гейты, зависящие от признаков и собирающие эмбеддинги из нескольких слоёв, а учитель использует частично доступные глубину и калибровку камер.
- Вероятностное выключение состояния (state dropout) снижает переобучение на демонстрационные траектории и усиливает опору на зрение.
- Вспомогательные компоненты нужны только при обучении, поэтому архитектура инференса не меняется и веса VLA можно использовать напрямую.
Почему это важно
Идея работы в том, чтобы пространственное понимание закладывалось не в узкой настройке под отдельную задачу, а уже на уровне базовой модели робота. По описанию авторов, современные VLA-модели берут зрительные представления из двумерного предобучения, из-за чего трёхмерный сигнал появляется поздно. SLA предлагает вводить его в непрерывное предобучение и сохранять при дальнейшей настройке.
Кому это важно
Исследователям и инженерам в робототехнике и машинном обучении, которые работают с VLA-политиками вроде pi05 и разнородными роботизированными наборами данных. Отдельный интерес, тем, кто хочет улучшить пространственное понимание, не усложняя модель на этапе инференса.
Как это применить
Из текста следует, что вспомогательные компоненты (выравнивание с 3D-моделью, гейты, state dropout) используются только в обучении, а предобученные веса VLA можно переиспользовать напрямую с прежней архитектурой инференса. О публикации кода или весов в тексте не сообщается, так что практическое применение пока зависит от полной статьи.
Можно ли доверять
Перед нами лишь описание метода от самих авторов. В тексте нет количественных результатов, сравнений с базовыми методами и исходной pi05, не названы авторы, наборы данных и используемая 3D-модель, поэтому судить об эффективности подхода по этому описанию нельзя. Утверждения о пользе метода, это заявления авторов, не подтверждённые здесь цифрами.
Риски и подводные камни
Эффект метода по имеющемуся тексту не измерен: нет данных, насколько он улучшает работу робота. Подход зависит от качества замороженной 3D-модели, служащей учителем, и от разнородных геометрических аннотаций (глубина и калибровка доступны лишь частично). Не описано и то, как метод проверяли на реальных роботах и в симуляции.