Show-Harness позволил VLM-агентам управлять роботами
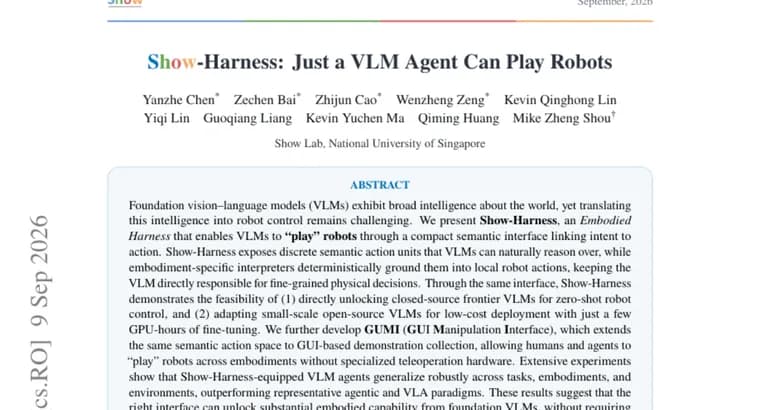
Show-Harness, интерфейс, который авторы называют Embodied Harness: он даёт VLM (vision-language модели, которая одновременно работает с изображением и текстом) возможность напрямую управлять роботом. Устроен он так: модель оперирует небольшим набором дискретных «семантических единиц действия», о которых ей естественно рассуждать, а отдельные интерпретаторы под конкретного робота детерминированно переводят эти единицы в его локальные команды. При этом мелкие физические решения по-прежнему принимает сама VLM, интерпретатор их не заменяет, а только переводит на язык конкретного робота.
Через один и тот же интерфейс авторы показывают два независимых сценария. Первый: мощная закрытая топовая VLM управляет роботом сразу, без какого-либо дополнительного обучения (zero-shot). Второй: компактную открытую VLM можно адаптировать для дешёвого развёртывания, дообучив её всего за несколько GPU-часов, без большого датасета и без долгого обучения под конкретную задачу.
Дополнительно авторы разработали GUMI (GUI Manipulation Interface), интерфейс, который расширяет тот же язык семантических действий на сбор демонстрационных данных через обычный графический интерфейс (GUI). Это позволяет людям и автоматическим агентам «играть» роботами разных типов, не имея специализированного оборудования для телеоперации.
По словам авторов, в обширных экспериментах агенты на основе Show-Harness устойчиво обобщаются на новые задачи, типы роботов и среды и превосходят типичные агентные и VLA-подходы (VLA, vision-language-action, модели, которые напрямую превращают изображение и текст в физическое действие). Конкретных цифр, успешности выполнения задач, числа сценариев, размера разрыва с другими подходами, в тексте не приведено. Вывод авторов: правильно спроектированный интерфейс способен раскрыть значительный «воплощённый» потенциал базовых VLM без увеличения размера модели и без дорогого предобучения под конкретную конструкцию робота. Один из авторов работы, Яньчжэ Чэнь (Yanzhe Chen); полный список соавторов и организаций в самой аннотации не указан.
Ключевые факты
- Show-Harness, компактный семантический интерфейс: VLM работает с дискретными «единицами действия», а интерпретаторы под конкретного робота детерминированно переводят их в его команды; мелкие физические решения остаются за VLM.
- Работает в двух режимах: мощная закрытая VLM управляет роботом zero-shot, без обучения; компактная открытая VLM дообучается под задачу всего за несколько GPU-часов.
- GUMI (GUI Manipulation Interface) расширяет тот же язык действий на сбор демонстраций через обычный графический интерфейс, без специализированного оборудования телеоперации.
- В экспериментах авторов агенты на Show-Harness обобщаются на новые задачи, роботов и среды и превосходят типичные агентные и VLA-подходы; точных цифр в тексте нет.
- Один из авторов, Яньчжэ Чэнь (Yanzhe Chen); полный список соавторов в аннотации не назван.
Почему это важно
Базовые VLM накопили широкие знания о мире, но перенести их в управление физическим роботом до сих пор было сложно: обычно для этого нужна либо VLA-модель, обученная под конкретного робота, либо серьёзное дообучение под каждую задачу. Show-Harness предлагает другой путь, тонкий семантический интерфейс поверх уже существующей VLM, а не новую модель с нуля. Он одинаково работает и с закрытыми топовыми моделями «из коробки» без обучения, и с компактными открытыми моделями, которым хватает нескольких GPU-часов дообучения: возможности, которые раньше требовали ресурсов топ-лаборатории, становятся доступны и небольшой команде.
Кому это важно
Разработчикам роботов и агентных систем, которым нужен способ подключить готовую VLM к управлению роботом без обучения отдельной VLA-модели с нуля. Командам без бюджета на крупномасштабное обучение, им подходит вариант с несколькими GPU-часами дообучения открытой модели. А через GUMI, всем, кому нужно собирать демонстрационные данные для разных роботов, но нет специализированного оборудования телеоперации: интерфейс работает через обычный графический интерфейс.
Как это применить
У Show-Harness два независимых сценария. Первый, подключить уже существующую закрытую топовую VLM к роботу через интерфейс без дополнительного обучения: подходит, когда важна скорость и нет собственной инфраструктуры для обучения. Второй, взять компактную открытую VLM и дообучить её под конкретную задачу или робота: по словам авторов, счёт идёт на единицы GPU-часов, а не на дни или кластер, поэтому порог входа для команды с ограниченным бюджетом невысокий. Дополнительно GUMI даёт способ собирать обучающие демонстрации через обычный графический интерфейс вместо специализированного контроллера телеоперации, что снижает порог для сбора данных на новых роботах.
Можно ли доверять
Это исследовательская работа, препринт с описанием метода и результатами «обширных экспериментов» от самих авторов, а не независимый аудит или воспроизведение третьей стороной. В самой аннотации нет ни конкретных цифр успешности, ни названий использованных роботов, задач или сред, ни сведений о рецензировании или месте публикации, оценить реальный размер преимущества над другими агентными и VLA-подходами можно будет только по полному тексту работы или по её независимой проверке, а не по аннотации.
Риски и подводные камни
Главный риск заложен в самой конструкции: интерпретаторы детерминированно переводят намерение VLM в команды робота, но не проверяют это намерение по существу, мелкие физические решения остаются за моделью, так что её ошибка или галлюцинация может напрямую отразиться на поведении физического робота. Второй риск, в аннотации нет цифр, поэтому неясно, насколько велик разрыв с другими подходами и на каких именно задачах и роботах он получен; заявленное «устойчивое обобщение» на новые задачи, роботов и среды пока можно оценить только качественно, со слов авторов.