SGF+: в генерации видео разделили параметры записи контекста и шумоподавления
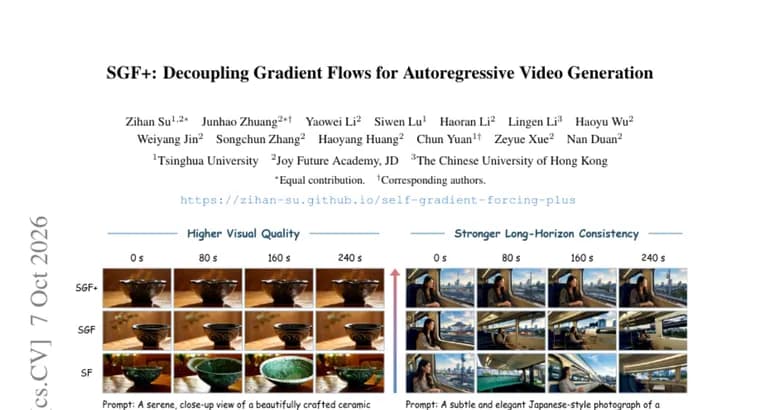
Авторегрессивная генерация видео требует двух вещей одновременно: очищать от шума текущие кадры и записывать их key-value-представления (ключи и значения внимания) как контекст для будущих предсказаний. Обычно эти две роли используют одни и те же параметры модели. Авторы статьи обнаружили, что градиенты этих ролей ведут себя по-разному и систематически направлены в противоположные стороны (отрицательное выравнивание). По их мнению, это мешает совместно оптимизировать визуальное качество и временную согласованность.
Как решение они предлагают метод Self Gradient Forcing Plus (SGF+). В нём для записи контекста и для шумоподавления выделены отдельные параметры, а взаимодействие между ролями сохраняется через каузальное внимание (causal attention). Обе роли обучаются совместно по исходной генеративной цели, без вспомогательных функций потерь; запись контекста при этом обучается по её вкладу в будущие предсказания.
Авторы утверждают, что такое простое изменение улучшает визуальное качество и согласованность на длинном горизонте по сравнению с проверенными базовыми методами, и при покадровой (framewise), и при поблочной (chunkwise) генерации. Для этого не понадобилось ни дополнительных видеоданных для обучения, ни более длинного горизонта обучения. Модель обучали только на 5-секундных фрагментах, но она, по заявлению авторов, поддерживает непрерывную генерацию длительностью до 24 часов без дообучения на длинных видео. Вывод авторов: параметризация по ролям, эффективный принцип проектирования для качественной авторегрессивной генерации видео и «родной» экстраполяции на длинный горизонт.
Ключевые факты
- В авторегрессивной генерации видео шумоподавление и запись контекста (key-value) обычно делят параметры; авторы находят у их градиентов разные паттерны и систематическое отрицательное выравнивание.
- SGF+ выделяет отдельные параметры для записи контекста и шумоподавления, сохраняя связь между ними через каузальное внимание.
- Обе роли обучаются совместно по исходной генеративной цели без вспомогательных потерь; запись контекста обучается по вкладу в будущие предсказания.
- Заявлено улучшение визуального качества и согласованности на длинном горизонте относительно проверенных базовых методов, без дополнительных видеоданных и более длинного горизонта обучения.
- После обучения только на 5-секундных фрагментах метод, по заявлению авторов, поддерживает непрерывную генерацию до 24 часов без дообучения на длинных видео.
Почему это важно
Главная трудность длинного видео, удерживать качество кадров и согласованность во времени одновременно. Работа указывает на конкретную причину конфликта: две роли делят параметры, а их градиенты противоречат друг другу. Если выводы авторов подтвердятся, это простой архитектурный принцип, который не требует ни новых данных, ни длинных обучающих клипов.
Кому это важно
Исследователям и инженерам, которые работают над авторегрессивными видеомоделями и длинной генерацией, а также тем, кто следит за способами избавиться от дообучения на длинных роликах.
Как это применить
В тексте источника нет сведений о коде, весах модели или условиях использования. Идею, разделить параметры записи контекста и шумоподавления, сохранив связь через каузальное внимание, можно изучать по самой статье как архитектурный приём.
Можно ли доверять
Все утверждения о качестве и о 24 часах принадлежат самим авторам. В тексте нет названий бенчмарков, значений метрик, процентов улучшения и списка базовых методов, с которыми шло сравнение. Цифра в 24 часа, заявление о поддержке непрерывной генерации; измерений качества на такой длине не приведено. Независимого подтверждения в источнике нет.
Риски и подводные камни
Улучшение заявлено только относительно «проверенных базовых методов», а не всех существующих. Не указаны размер модели и вычислительные затраты, поэтому оценить цену отдельных параметров нельзя. Возможность генерировать 24 часа ещё не значит, что качество и согласованность сохраняются на всём этом протяжении.