Бенчмарк SWE-Game: ИИ-агенты набирают меньше 60 из 100 в создании игр на Godot
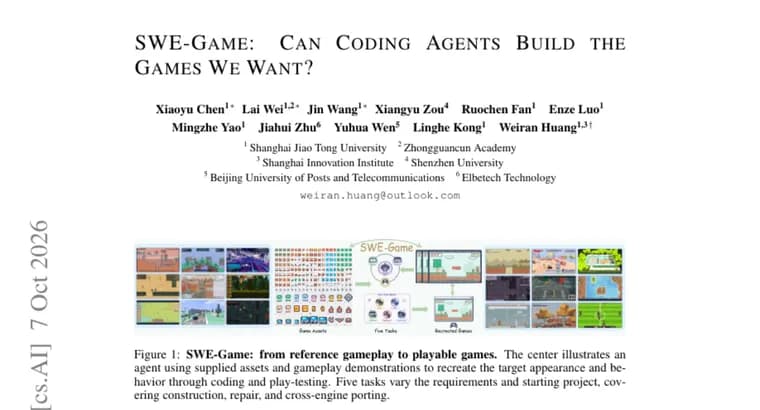
Авторы представили SWE-Game, бенчмарк из 247 задач, построенных на 41 исполняемой эталонной игре на движке Godot. Игры охватывают 13 игровых категорий, в 2D и 3D. Цель, проверить, насколько ИИ-агенты для программирования способны не просто писать код, а справляться с разными задачами разработки игр.
Задачи делятся на пять типов: разработка игры по краткому описанию, реализация по игровому дизайн-документу, достройка заготовки (skeleton), починка 83 случаев с внесёнными ошибками и перенос игры с Godot на Unity. Эталонные материалы описывают задуманный геймплей, а общий интерфейс инструментирования позволяет драйверам и пробам, которыми владеет оценщик, выполнять действия и наблюдать за независимо написанными играми.
Оценка комбинирует три источника: проверки состояния движка, воспроизведение сертифицированных эталонных вводов и демонстрации функций, которые готовит сам агент. Так измеряются корректность механик, показанная играбельность, а после починки, восстановление и сохранение поведения. Подача и внешний вид оцениваются отдельно: для каждой игры составлены рубрики для визуально-языковых моделей.
Результаты. Среди шести моделей Opus5 получила наивысший общий балл во всех пяти типах задач. При этом лучшие общие баллы по трём задачам создания игр остаются ниже 60 из 100; на задаче Brief-to-Game лучший результат, 50,38. Разбор проверенных решений показывает, что главные проблемы реализации, пропуск требований и ошибки в игровой логике.
Авторы также проверили сам метод оценки. На размеченном людьми поведении 100 игр, созданных агентами, исполняемые проверки дали сбалансированную точность 92,59% против 78,41% у судьи на основе видео и визуально-языковой модели. Баллы по рубрикам для визуальной оценки коррелируют с оценками людей по 200 клипам геймплея с коэффициентом Спирмена 0,829. Вывод: результаты характеризуют текущие возможности агентов в разработке игр и подтверждают смысл сочетать данные о работе игры во время выполнения с визуальной оценкой.
Ключевые факты
- SWE-Game, бенчмарк из 247 задач на основе 41 исполняемой эталонной игры на Godot, 13 игровых категорий, 2D и 3D.
- Пять типов задач: разработка по краткому описанию, реализация по дизайн-документу, достройка заготовки, починка 83 случаев с внесёнными ошибками, перенос с Godot на Unity.
- Из шести моделей Opus5 лидирует во всех пяти типах задач, но лучшие общие баллы по трём задачам создания игр ниже 60 из 100; на Brief-to-Game лучший результат, 50,38.
- Главные проблемы реализации: пропуск требований и ошибки игровой логики.
- Исполняемые проверки совпали с разметкой людей точнее (92,59% сбалансированной точности), чем видео-судья на основе визуально-языковой модели (78,41%).
Почему это важно
Игры, задача, где мало написать компилирующийся код: нужны работающие механики, играбельность и приемлемая подача. SWE-Game измеряет это на исполняемых эталонных играх, а не по тексту кода. Главный итог: даже лучшая модель из шести, Opus5, остаётся ниже 60 баллов из 100 на трёх задачах создания игр, а на Brief-to-Game лучший результат, 50,38. Значит, самостоятельная разработка игр агентами пока далека от надёжной.
Кому это важно
Исследователям и разработчикам кодинг-агентов: бенчмарк даёт способ измерять работу агента на игровых проектах, включая починку и перенос между движками. Разработчикам игр на Godot и Unity, как ориентир текущих возможностей агентов в разных видах игровой разработки. Выводы по частоте ошибок (пропуск требований, логика геймплея) полезны всем, кто строит процессы проверки результатов агентов.
Как это применить
Из аннотации следует практический принцип оценки: сочетать проверки состояния движка и воспроизведение эталонных вводов с визуальной оценкой, а не полагаться на один видео-судью. Исполняемые проверки в работе авторов оказались точнее (92,59% против 78,41% сбалансированной точности). При ручном использовании агентов для игр стоит особенно проверять, что все требования из описания реализованы и что игровая логика работает.
Можно ли доверять
Источник, аннотация научной работы, опубликованной на Hugging Face Papers; все цифры приведены самими авторами и не перепроверялись независимо. Метод оценки при этом подкреплён собственными проверками: сравнением с разметкой людей по 100 играм и корреляцией 0,829 по 200 клипам. Из аннотации не видно, какие ещё модели вошли в сравнение кроме Opus5 и какие баллы они получили, поэтому судить о разрыве между моделями нельзя.
Риски и подводные камни
Бенчмарк построен на одном движке (Godot) и 41 эталонной игре, а перенос идёт только в сторону Unity, поэтому обобщать результаты на любую разработку игр рано. Число 50,38 относится к Brief-to-Game как лучшему общему результату; не следует считать, что это балл именно Opus5. Оценка отчасти опирается на модели, понимающие изображение и видео, а их судейство в работе оказалось менее точным, чем исполняемые проверки.