Qwen 3.5 на 4 млрд параметров обошла GPT-5.6 в бенчмарке для киосков метро
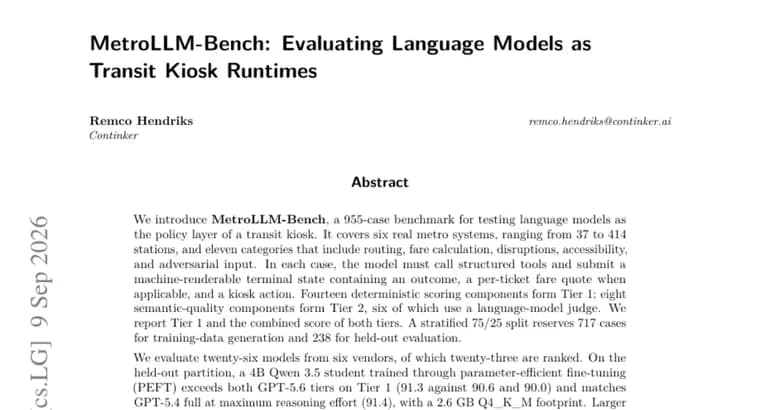
Авторы (источник не называет ни имён, ни организации) представили MetroLLM-Bench, бенчмарк из 955 тестовых случаев, который проверяет языковые модели в роли системы, принимающей решения за билетный киоск метро. В основу легли шесть реальных систем метро, от 37 до 414 станций, и одиннадцать категорий задач: маршрутизация, расчёт тарифа, реакция на сбои в расписании, доступность, состязательные (намеренно провокационные) запросы и другие. В каждом случае модель обязана вызывать заданные инструменты и в итоге выдать машиночитаемое финальное состояние, которое киоск может напрямую отобразить: результат обращения, стоимость билета (если применимо) и действие, которое киоск должен выполнить дальше.
Оценка построена в два уровня. Первый (Tier 1), четырнадцать детерминированных, формально проверяемых компонентов. Второй (Tier 2), восемь компонентов смыслового качества, шесть из которых оценивает сама языковая модель в роли судьи (LLM-as-judge). Авторы публикуют и балл по Tier 1, и совокупный балл по обоим уровням. Все 955 случаев разделены в пропорции 75/25: 717 ушли на генерацию обучающих данных, 238 остались для отложенной (held-out) проверки.
Всего протестировали 26 моделей от шести поставщиков, в итоговый рейтинг попали 23. Главный результат: на отложенной выборке компактная модель, Qwen 3.5 на 4 млрд параметров, дообученная методом экономного дообучения части параметров (PEFT), набрала по Tier 1 91,3 балла. Это выше обоих вариантов GPT-5.6 (90,6 и 90,0, источник не уточняет, какой именно вариант получил какой балл) и на уровне полной версии GPT-5.4 с максимальным уровнем рассуждений (91,4 балла). При этом сама модель в формате квантования Q4_K_M весит всего 2,6 ГБ.
Масштаб не помогает автоматически: более крупные студенческие модели на 9 и 27 млрд параметров не дали дальнейшего прироста по Tier 1 относительно 4-миллиардной при том же объёме обучения. Больше того, выигрыш от PEFT-дообучения по сравнению с базовой моделью падает с ростом размера, от +7,03 балла у 2-миллиардной версии (по трём обучающим сидам) до -0,91 у 27-миллиардной, то есть у самой крупной модели такое дообучение уже слегка ухудшает результат; направление этого эффекта авторы наблюдали одинаковым для каждого использованного сида на каждом размере.
Для сравнения: простой детерминированный алгоритм без единой нейросети набирает по Tier 1 84,6 балла, это базовая линия теста. Оставшееся преимущество языковых моделей над ней сосредоточено в адаптации к правилам, составных сценариях, доступности и рассуждениях о времени. При этом в общем (композитном) рейтинге, объединяющем оба уровня, лидирует не GPT- и не Qwen-модель, а модель Muse Glimmer 30B. Авторы отдельно показывают, что одна лишь смена конфигурации, с которой запущена модель, сдвигает сравнение Qwen 3.5 и Qwen 3.8 на 2,7 балла по Tier 1, то есть часть разницы между версиями объясняется настройками запуска, а не только самой моделью.
Бенчмарк, тестовую инфраструктуру (harness), руководство по воспроизведению результатов и сами дообученные модели авторы выложили в открытый доступ на GitHub (continker/metrollm-bench).
Ключевые факты
- MetroLLM-Bench, 955 тестовых случаев на проверку языковых моделей в роли билетного киоска метро: шесть реальных систем метро (37, 414 станций), одиннадцать категорий задач вроде маршрутизации, расчёта тарифа, сбоев в расписании, доступности и состязательных запросов.
- На отложенной выборке компактная Qwen 3.5 на 4 млрд параметров, дообученная методом PEFT, набрала 91,3 балла по Tier 1, выше обоих вариантов GPT-5.6 (90,6 и 90,0) и на уровне полной версии GPT-5.4 с максимальными рассуждениями (91,4); модель весит 2,6 ГБ.
- Масштаб не помогает линейно: 9- и 27-миллиардные версии не дали прироста по Tier 1 относительно 4-миллиардной, а выигрыш от PEFT падает с размером, от +7,03 балла у 2-миллиардной версии до -0,91 у 27-миллиардной.
- Всего оценили 26 моделей от шести поставщиков (в рейтинге, 23); композитный рейтинг, объединяющий оба уровня оценки, возглавила не GPT- и не Qwen-модель, а Muse Glimmer 30B.
- Простая смена конфигурации, с которой запущена модель, сдвигает сравнение Qwen 3.5 и Qwen 3.8 на 2,7 балла по Tier 1. Бенчмарк, тестовая инфраструктура, инструкция по воспроизведению и сами дообученные модели выложены на GitHub (continker/metrollm-bench).
Почему это важно
MetroLLM-Bench показывает, что для узкой, но жёстко регламентированной задачи, обслуживания билетного киоска метро, маленькая модель, дообученная методом PEFT, может обойти по формальным (детерминированным) метрикам куда более крупные и дорогие модели вроде GPT-5.6, а по части показателей выйти на уровень GPT-5.4 в режиме максимальных рассуждений. Это не общий вывод о превосходстве маленьких моделей над большими, источник прямо показывает, что при увеличении студенческой модели с 4 до 9 и 27 млрд параметров прирост по Tier 1 прекращается, а выигрыш от PEFT на самом большом размере становится отрицательным. Ценность именно в границах: там, где задача жёстко структурирована, фиксированные инструменты, проверяемый формат ответа, небольшая специализированная модель оказывается рабочей и дешёвой альтернативой крупной универсальной.
Кому это важно
Тем, кто строит похожие системы с жёстким протоколом ответа: киоски и терминалы транспорта, справочные и билетные автоматы, любые интерфейсы с ограниченным набором действий и проверяемым выходом, бенчмарк и код можно взять за основу для собственной оценки. Инженерам, которые выбирают между большой моделью по API и маленькой дообученной локальной моделью для узкой задачи, как ориентир по соотношению качества и размера. Тем, кто использует языковую модель как судью (LLM-as-judge) в собственных бенчмарках, как пример архитектуры оценки с явным разделением на детерминированный и смысловой уровень.
Как это применить
Авторы выложили в открытый доступ на GitHub (continker/metrollm-bench) сам бенчмарк, тестовую инфраструктуру, руководство по воспроизведению результатов и уже дообученные модели, чьи веса можно скачать и запустить локально без переобучения. Компактный размер лучшей модели (2,6 ГБ в формате Q4_K_M) делает её пригодной для локального или встроенного развёртывания прямо на киоске, без обращения к внешнему API. Но прежде чем переносить вывод «маленькая модель не хуже большой» на свою задачу, стоит проверить, насколько она структурирована так же жёстко, как задачи этого бенчмарка: авторы прямо показывают, что на менее детерминированных подзадачах, составных сценариях, адаптации к правилам, доступности, отрыв языковых моделей от простого алгоритма гораздо заметнее, чем в среднем по Tier 1.
Можно ли доверять
Источник не называет ни авторов, ни организации, ни шести поставщиков протестированных моделей, проверить эти данные по самому тексту нельзя. Явно на отложенной выборке получено только сравнение 4-миллиардной Qwen 3.5 с GPT-5.6 и GPT-5.4; для остальных цифр, базовой линии 84,6, сравнения 9- и 27-миллиардных версий, шагов PEFT-выигрыша, эффекта конфигурации запуска на 2,7 балла, источник не уточняет, на какой именно части данных они получены. Два варианта GPT-5.6 (90,6 и 90,0 балла) в тексте не подписаны, поэтому нельзя сказать, какой конфигурации какой балл принадлежит. Отдельная оговорка касается методики: шесть из восьми компонентов Tier 2 оценивает сама языковая модель в роли судьи, а такая схема по своей природе может отражать предпочтения модели-судьи не меньше, чем реальное качество ответа, источник эту особенность отдельно не обсуждает. Зато сам бенчмарк и код воспроизведения открыты, так что итоговые цифры в принципе можно перепроверить. В плюс источнику то, что он сам приводит данные, которые работают против его же громкого результата: отсутствие прироста у более крупных версий, уход PEFT-выигрыша в минус на 27 млрд параметров и чувствительность сравнения моделей к конфигурации запуска.
Риски и подводные камни
Главный риск, принять частный результат за общее правило. Маленькая модель выигрывает у GPT-5.6 только по Tier 1 (формальным, детерминированным критериям); в общем рейтинге, где учтён ещё и смысловой Tier 2, лидирует не она и не GPT-модель, а Muse Glimmer 30B. Масштабирование не работает линейно: рост студенческой модели с 4 до 9 и 27 млрд параметров не даёт прироста по Tier 1, а PEFT-дообучение на 27 млрд параметрах уже слегка вредит результату по сравнению с базовой моделью. Сравнения моделей чувствительны к тому, как их разворачивают: одна лишь смена конфигурации запуска меняет разрыв между Qwen 3.5 и Qwen 3.8 на 2,7 балла по Tier 1, то есть часть места в рейтинге определяется тем, как модель развёрнута, а не только её весами. Наконец, весь бенчмарк построен на шести конкретных системах метро с их наборами правил; переносится ли результат на другие города, на наземный транспорт или на задачи вне транспорта, источник не говорит.