Почему нейросетям всё ещё дорого обрабатывать видео: вышел обзор способов ускорения
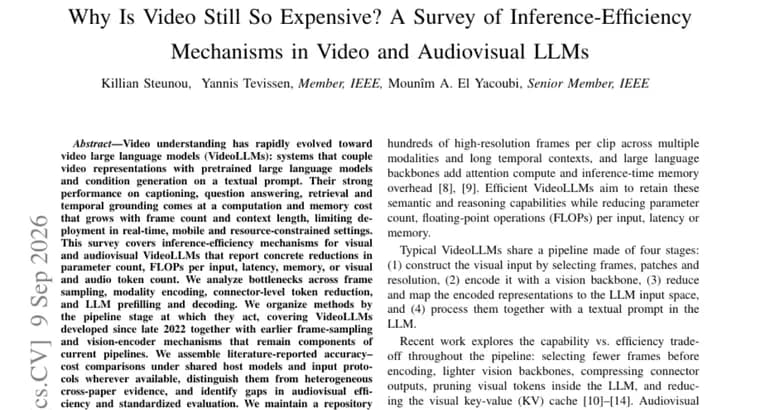
Видео-нейросети последнего поколения (VideoLLM, video large language models) соединяют представление видео с уже обученной большой языковой моделью и строят ответ по текстовому запросу. Такие системы хорошо справляются с описанием происходящего в ролике, ответами на вопросы по видео, поиском нужных сцен и точным определением момента, к которому относится запрос, но это качество стоит дорого: вычислительные и денежные затраты растут вместе с числом обрабатываемых кадров и длиной контекста, из-за чего такие модели трудно запускать в реальном времени, на мобильных устройствах и там, где вычислительных ресурсов мало.
Новый обзор систематизирует способы удешевить эту работу, методы, которые дают измеримое снижение числа параметров модели, объёма вычислений на один вход (FLOPs), задержки ответа, объёма памяти или количества визуальных и звуковых токенов; речь идёт как о моделях, которые работают только с видеорядом, так и о тех, что обрабатывают видео вместе со звуком. Авторы разбирают узкие места по четырём точкам конвейера обработки: отбор кадров (какие кадры вообще брать в работу), кодирование видео и звука в представление, понятное языковой модели, сокращение числа токенов на стыке визуального энкодера и языковой модели, и, наконец, этапы предзаполнения контекста и генерации ответа в самой языковой модели. Методы сгруппированы по тому, на какой из этих стадий они экономят ресурсы; обзор охватывает видео-нейросети, появившиеся начиная с конца 2022 года, а также более ранние механизмы отбора кадров и визуального кодирования, которые до сих пор остаются частью современных систем.
Там, где это возможно, авторы сводят в таблицы результаты «точность против затрат» для методов, измеренных на одинаковых базовых моделях и по одинаковому протоколу входных данных, и отдельно помечают случаи, когда сравнение получено из разных, не сопоставимых напрямую работ. Они также прямо указывают, что по эффективности аудиовизуальных моделей и по единой методике оценки в целом данных пока недостаточно. Авторы поддерживают сопроводительный репозиторий на GitHub (momentslab/awesome-efficient-videollm); что именно в нём выложено, в описании обзора не уточняется.
Ключевые факты
- Обзор охватывает видео-нейросети (VideoLLM) с конца 2022 года и группирует методы ускорения по четырём узким местам конвейера: отбор кадров, кодирование видео и звука, сокращение токенов на стыке энкодера и языковой модели, работа самой языковой модели (предзаполнение контекста и генерация ответа).
- Берутся только методы с измеримым эффектом: меньше параметров модели, меньше вычислений (FLOPs) на один вход, ниже задержка ответа и объём памяти, меньше визуальных или звуковых токенов.
- Отдельно разбираются модели, которые обрабатывают только видео, и аудиовизуальные модели, которые дополнительно обрабатывают звук.
- Там, где условия сравнимы, результаты разных методов сведены в таблицы «точность против затрат» на одинаковых базовых моделях, и отделены от разнородных сравнений из разных статей.
- Авторы отмечают нехватку данных по эффективности аудиовизуальных моделей и единой методики оценки, а также поддерживают сопроводительный репозиторий на GitHub (momentslab/awesome-efficient-videollm).
Почему это важно
Видео-нейросети (VideoLLM) всё лучше справляются с описанием происходящего в видео, ответами на вопросы по ролику, поиском нужных сцен и точным определением момента, к которому относится запрос, но эти возможности стоят дорого: вычислительные и денежные затраты растут вместе с числом обрабатываемых кадров и длиной контекста. Это напрямую определяет, где такую модель вообще можно запустить: в реальном времени, на телефоне, на слабом сервере, или только в дата-центре с большим бюджетом на вычисления. Обзор сводит в одну карту разрозненные приёмы, которые снижают эту стоимость на разных этапах обработки видео, от того, какие кадры вообще брать в работу, до экономии токенов уже внутри языковой модели.
Кому это важно
В первую очередь, инженерам и исследователям, которые строят или встраивают видео-нейросети в продукт: подписи и описания к видео, ответы на вопросы о происходящем в ролике, поиск нужных сцен или момента в видео. Обзор пригодится и тем, кто выбирает конкретный метод под конкретное узкое место в своём конвейере обработки, например, если проблема именно в отборе кадров, а не в самой языковой модели. Отдельно он полезен командам, которым нужно уместить видео-нейросеть в ограниченный бюджет по памяти или задержке ответа: в тексте прямо говорится про запуск в реальном времени, на мобильных устройствах и при ограниченных вычислительных ресурсах.
Как это применить
Обзор устроен как карта: методы сгруппированы по тому, на каком этапе обработки видео они экономят ресурсы, отбор кадров, кодирование видео и звука в представление для модели, сокращение токенов на стыке энкодера и языковой модели или ускорение самой языковой модели при предзаполнении контекста и генерации ответа. Это позволяет искать решение не «вообще по эффективности», а под конкретную проблему: если узкое место, объём данных на входе, стоит смотреть блок про отбор кадров и кодирование, если узкое место, скорость генерации ответа, то блок про языковую модель. Там, где авторы нашли сопоставимые по условиям измерения (одна и та же базовая модель, один протокол входных данных), они свели их в таблицы «точность против затрат», с них разумно начинать выбор конкретного метода. К обзору прилагается репозиторий на GitHub (momentslab/awesome-efficient-videollm); что именно там выложено, код, перечень статей или что-то ещё, в описании обзора не сказано, и это стоит проверить отдельно.
Можно ли доверять
Это обзорная работа: она не предлагает новый метод, а систематизирует уже опубликованные результаты других авторов, поэтому качество каждого конкретного вывода зависит от качества исходных статей, а не только от самого обзора. В его пользу говорит то, что авторы сами разделяют два типа сравнений, измерения разных методов на одинаковой базовой модели и по одному протоколу и разнородные результаты, взятые из разных статей с разными условиями, и не выдают второе за первое. При этом в открытом описании обзора не указаны ни авторы, ни организация, ни конкретные цифры прироста эффективности для отдельных методов, ни площадка и точная дата публикации: эти детали стоит смотреть в самой статье или в связанном репозитории, а не только в аннотации.
Риски и подводные камни
Область меняется быстро: сам обзор охватывает методы начиная с конца 2022 года, и часть материала рискует устареть быстрее, чем выходят новые видео-нейросети. Авторы прямо указывают на нехватку стандартизированной методики оценки эффективности и на пробелы именно в оценке аудиовизуальных моделей, тех, что обрабатывают видео вместе со звуком. Часть сравнений в литературе, которую разбирает обзор, получена в разных условиях и на разных базовых моделях, и авторы сами предупреждают не путать такие результаты с экспериментами на одной и той же базе.