QDA: ИИ-агент сам подбирает квантизацию LLM и даёт +0,9-2,2 п.п. точности
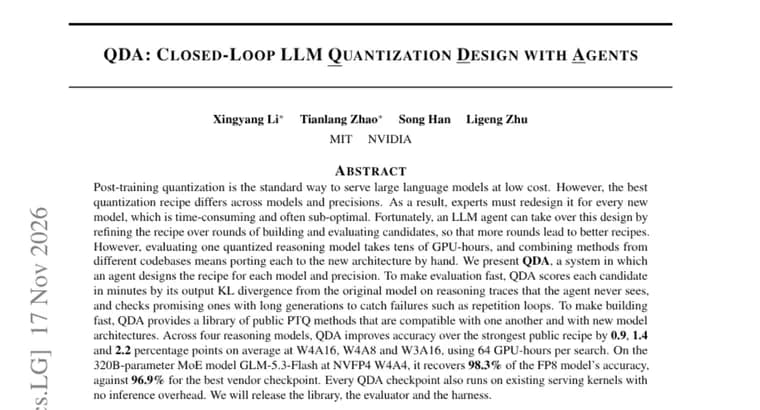
Посттренировочная квантизация (PTQ), стандартный способ дёшево запускать большие языковые модели. Проблема в том, что лучший рецепт квантизации разный для разных моделей и разрядностей, поэтому эксперты вынуждены заново проектировать его под каждую новую модель. По словам авторов, это долго и часто даёт неоптимальный результат.
Авторы предлагают QDA, систему, в которой этот рецепт для каждой модели и разрядности проектирует LLM-агент. Он уточняет рецепт по кругам: собирает кандидатов и оценивает их, и чем больше кругов, тем лучше рецепт. Мешали две вещи: оценка одной квантованной «рассуждающей» модели занимает десятки GPU-часов, а объединение методов из разных кодовых баз требует вручную переносить каждый на новую архитектуру.
QDA отвечает на это двумя приёмами. Для быстрой оценки каждый кандидат за минуты оценивается по KL-дивергенции его выходов относительно исходной модели на трассах рассуждений, которых агент не видит. Перспективных кандидатов дополнительно проверяют длинными генерациями, чтобы поймать сбои вроде зацикливания повторов. Для быстрой сборки QDA даёт библиотеку публичных PTQ-методов, совместимых друг с другом и с новыми архитектурами моделей.
Результаты. На четырёх рассуждающих моделях QDA повышает точность относительно сильнейшего публичного рецепта в среднем на 0,9 п.п. при W4A16, на 1,4 п.п. при W4A8 и на 2,2 п.п. при W3A16; на один поиск уходит 64 GPU-часа. На MoE-модели GLM-5.3-Flash (320 млрд параметров) при NVFP4 W4A4 QDA восстанавливает 98,3% точности FP8-модели против 96,9% у лучшего чекпойнта от вендора. Авторы также утверждают, что каждый чекпойнт QDA работает на существующих серверных ядрах без дополнительных накладных расходов на инференс. Библиотеку, оценщик и обвязку (harness) обещают выложить.
Ключевые факты
- QDA, система, где LLM-агент проектирует рецепт посттренировочной квантизации под каждую модель и разрядность, уточняя его по кругам «собрать, оценить».
- Кандидатов оценивают за минуты по KL-дивергенции выходов относительно исходной модели на трассах рассуждений, которых агент не видит; перспективные проверяют длинными генерациями на сбои вроде зацикливания.
- На четырёх рассуждающих моделях средний выигрыш над сильнейшим публичным рецептом: 0,9 п.п. (W4A16), 1,4 п.п. (W4A8), 2,2 п.п. (W3A16); один поиск, 64 GPU-часа.
- На GLM-5.3-Flash (MoE, 320 млрд параметров) при NVFP4 W4A4 QDA сохраняет 98,3% точности FP8-модели против 96,9% у лучшего чекпойнта вендора.
- Авторы заявляют, что чекпойнты работают на существующих серверных ядрах без накладных расходов на инференс, и обещают выложить библиотеку, оценщик и обвязку.
Почему это важно
Квантизация, основной способ удешевить запуск больших моделей, но рецепт приходится подбирать под каждую новую модель вручную. QDA пытается автоматизировать этот подбор: агент перебирает и комбинирует публичные методы, а дешёвая оценка по KL-дивергенции вместо десятков GPU-часов на полноценную проверку делает такой перебор практичным. По заявлению авторов, один поиск занимает 64 GPU-часа.
Кому это важно
Командам, которые сами разворачивают рассуждающие модели и квантизуют их под низкую разрядность (W4A16, W4A8, W3A16, NVFP4 W4A4), а также исследователям, которые занимаются квантизацией и автоматизацией подбора рецептов агентами.
Как это применить
Пока это описание метода: авторы пишут, что выложат библиотеку, оценщик и обвязку, но в источнике нет ни даты, ни ссылки на выпуск. Практически стоит дождаться публикации кода. Из заявленного: чекпойнты QDA запускаются на существующих серверных ядрах без накладных расходов на инференс, то есть сам результат не требует нового рантайма.
Можно ли доверять
Все цифры взяты из аннотации и представляют собой заявления самих авторов. В источнике не названы авторы и организации, четыре рассуждающие модели (кроме GLM-5.3-Flash), метрики и бенчмарки, за которыми стоят проценты, а также не указано, какой агент или LLM управляет QDA. Выигрыш в п.п. приведён относительно сильнейшего публичного рецепта без абсолютных значений точности; 98,3% и 96,9%, доли точности FP8-модели, а не абсолютная точность, вендор не назван. Код пока только обещан.
Риски и подводные камни
Средний выигрыш в 0,9-1,4 п.п. при W4A16 и W4A8 скромный и может зависеть от набора моделей и метрик, которые не названы. Оценка кандидатов по KL-дивергенции, прокси, поэтому авторы добавляют проверку длинными генерациями на сбои вроде зацикливания; насколько этого хватает в других условиях, из источника неясно. Результаты привязаны к рассуждающим моделям и к заявленным бюджетам поиска в 64 GPU-часа.