Представлена FastFrames: генерация видео за 36 мс на кадр на одной B200
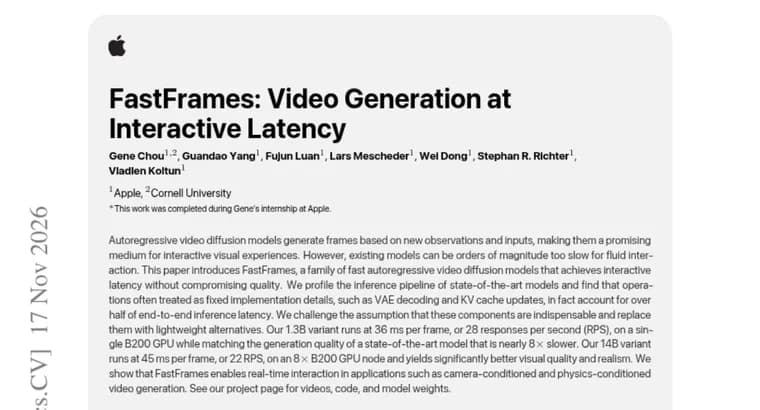
В статье, опубликованной на странице Hugging Face Papers, представлено FastFrames, семейство быстрых авторегрессионных видеодиффузионных моделей. Такие модели генерируют кадры по мере поступления новых наблюдений и входных данных, поэтому считаются перспективной основой для интерактивных визуальных сред. Но, по словам авторов, существующие модели на порядки медленнее, чем нужно для плавного взаимодействия.
Авторы профилировали конвейер вывода у современных моделей и обнаружили, что операции, которые обычно считают неизменной деталью реализации, декодирование VAE и обновление KV-кэша, вместе занимают больше половины сквозной задержки. Доли каждой из операций по отдельности в аннотации не названы. Авторы ставят под сомнение, что эти компоненты незаменимы, и заменяют оба лёгкими альтернативами. Что именно за альтернативы, в аннотации не раскрыто.
Результаты. Вариант на 1,3 млрд параметров работает со скоростью 36 мс на кадр, или 28 ответов в секунду (RPS), на одной GPU B200 и, как утверждают авторы, по качеству генерации не уступает современной модели, которая почти в 8 раз медленнее. Вариант на 14 млрд параметров выдаёт кадр за 45 мс (22 RPS) на узле из 8 GPU B200 и, по заявлению авторов, даёт заметно лучшее визуальное качество и реалистичность; с чем именно идёт сравнение, в аннотации не сказано. Авторы показывают, что FastFrames позволяет работать в реальном времени в таких задачах, как генерация видео с управлением камерой и с управлением физикой.
Ключевые факты
- FastFrames, семейство авторегрессионных видеодиффузионных моделей, нацеленное на интерактивную задержку без потери качества.
- Профилирование показало: декодирование VAE и обновление KV-кэша вместе занимают больше половины сквозной задержки вывода; авторы заменили оба компонента лёгкими альтернативами.
- Вариант на 1,3 млрд параметров: 36 мс на кадр (28 RPS) на одной B200; по заявлению авторов, качество на уровне современной модели, которая почти в 8 раз медленнее.
- Вариант на 14 млрд параметров: 45 мс на кадр (22 RPS) на узле из 8 B200; авторы заявляют значительно лучшее визуальное качество и реалистичность.
- Показаны применения: генерация видео с управлением камерой и с управлением физикой в реальном времени.
Почему это важно
Интерактивное видео, которое генерируется в ответ на действия пользователя, упирается в задержку: по словам авторов, существующие авторегрессионные модели на порядки медленнее, чем нужно для плавного взаимодействия. Работа указывает на неожиданный источник потерь: не сама диффузия, а декодирование VAE и обновление KV-кэша, которые вместе дают больше половины задержки. Если вывод авторов подтвердится, ускорение можно искать в этих «служебных» компонентах, а не только в самой модели.
Кому это важно
Исследователям видеогенерации и мировых моделей, а также командам, которые строят интерактивные сценарии: управление камерой, физически обусловленная генерация. Инженерам по выводу моделей полезно само наблюдение о том, что VAE-декодер и KV-кэш могут быть главным узким местом.
Как это применить
В аннотации не сказано, опубликованы ли код, веса или демо, поэтому напрямую воспользоваться моделью по этому тексту нельзя. Практический вывод на сегодня, методический: профилировать собственный конвейер вывода и проверять, не занимают ли декодирование VAE и обновление KV-кэша непропорционально много времени. Железо в заявленных замерах дорогое: одна B200 для варианта на 1,3 млрд параметров и узел из 8 B200 для варианта на 14 млрд.
Можно ли доверять
Все цифры взяты из аннотации и являются заявлениями самих авторов; независимой проверки в тексте нет. Авторы и их организации в аннотации не названы. Модель, по качеству которой сравнивается вариант на 1,3 млрд параметров, не названа, метрики качества не приведены. Для варианта на 14 млрд параметров не указано, с чем сравнивается «значительно лучшее» качество. Разрешение видео и длина контекста для замеров задержки тоже не указаны.
Риски и подводные камни
Заявленные 36 и 45 мс на кадр относятся к конкретному железу (B200) и неизвестным параметрам видео, так что на других конфигурациях результат может отличаться. Утверждение «без потери качества» опирается на сравнение с неназванной моделью и не подкреплено в аннотации метриками. Состав лёгких замен VAE-декодера и KV-кэша не раскрыт, поэтому оценить, чем за скорость пришлось пожертвовать, по этому тексту нельзя. Вариант на 14 млрд параметров требует узла из 8 GPU, что ограничивает доступность.
«Мы ставим под сомнение предположение, что эти компоненты незаменимы, и заменяем их лёгкими альтернативами.»
— из аннотации статьи FastFrames