Простой RAG обошёл сложную агентную память в шести из семи тестовых настроек
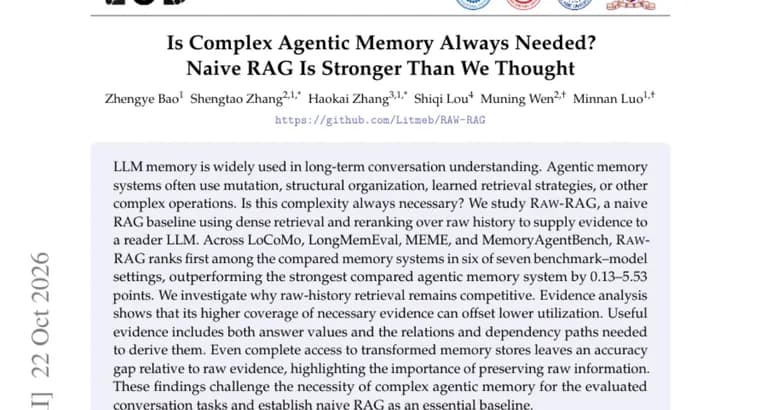
Авторы препринта задаются вопросом: всегда ли нужна сложность в системах памяти для больших языковых моделей, которые применяют для понимания долгих диалогов. Агентные системы памяти часто используют изменение записей, структурную организацию, обученные стратегии поиска и другие сложные операции.
Для проверки авторы взяли Raw-RAG, наивный RAG-базис (поиск по базе с генерацией ответа). Он применяет плотный поиск (dense retrieval) и переранжирование по необработанной истории диалога, чтобы передать найденные свидетельства читающей языковой модели (reader LLM).
Сравнение шло на четырёх бенчмарках: LoCoMo, LongMemEval, MEME и MemoryAgentBench. Raw-RAG занял первое место среди сравниваемых систем памяти в шести из семи настроек «бенчмарк, модель». От сильнейшей из сравниваемых агентных систем памяти он отличался на 0,13-5,53 пункта.
Далее авторы разбирают, почему поиск по сырой истории остаётся конкурентоспособным. По их анализу свидетельств, более высокое покрытие нужных свидетельств может компенсировать более низкое их использование. Полезные свидетельства включают не только значения ответов, но и связи и цепочки зависимостей, нужные для их вывода. Даже полный доступ к преобразованным хранилищам памяти оставляет разрыв в точности по сравнению с сырыми свидетельствами, это подчёркивает важность сохранения исходной информации.
Вывод авторов: результаты ставят под сомнение необходимость сложной агентной памяти для оценённых диалоговых задач и закрепляют наивный RAG как обязательный базовый ориентир.
Ключевые факты
- Raw-RAG (плотный поиск и переранжирование по необработанной истории диалога) ранжируется первым среди сравниваемых систем памяти в шести из семи настроек «бенчмарк, модель».
- Тесты проведены на LoCoMo, LongMemEval, MEME и MemoryAgentBench.
- Преимущество над сильнейшей сравниваемой агентной системой памяти составляет 0,13-5,53 пункта.
- Объяснение авторов: высокое покрытие нужных свидетельств может компенсировать их менее эффективное использование.
- Даже полный доступ к преобразованной памяти не догоняет по точности сырые свидетельства; вывод ограничен оценёнными диалоговыми задачами.
Почему это важно
Системы агентной памяти усложняются: изменение записей, структурирование, обученный поиск. Работа проверяет, окупается ли эта сложность, и показывает, что простой базис с поиском по сырой истории в большинстве настроек оказывается впереди. По выводу авторов, наивный RAG должен считаться обязательным базовым ориентиром при сравнении систем памяти.
Кому это важно
Разработчикам и исследователям, которые строят память для диалоговых ассистентов и агентов, а также тем, кто выбирает между сложной системой памяти и простым поиском по истории переписки.
Как это применить
Перед внедрением сложной агентной памяти стоит сравнить её с простым базисом: плотный поиск и переранжирование по необработанной истории, результат которого получает читающая модель. Также авторы указывают на ценность сохранения исходных данных, а не только их преобразованных версий.
Можно ли доверять
Это препринт, представленный на странице Hugging Face в виде аннотации. Из аннотации не видно, какие именно агентные системы сравнивались, какая метрика стоит за «пунктами» и в какой настройке Raw-RAG первым не стал. Вывод сформулирован авторами осторожно: только для оценённых диалоговых задач.
Риски и подводные камни
Размер преимущества указан диапазоном 0,13-5,53 пункта, и из аннотации не ясно, как он распределён по настройкам. Результат относится к четырём указанным бенчмаркам диалоговой памяти и не обязательно переносится на другие задачи. Сведений о стоимости, задержке и расходе токенов в аннотации нет, поэтому сравнить системы по этим параметрам нельзя.