Deep Fusion Memory: память для языковых моделей без поиска при выводе
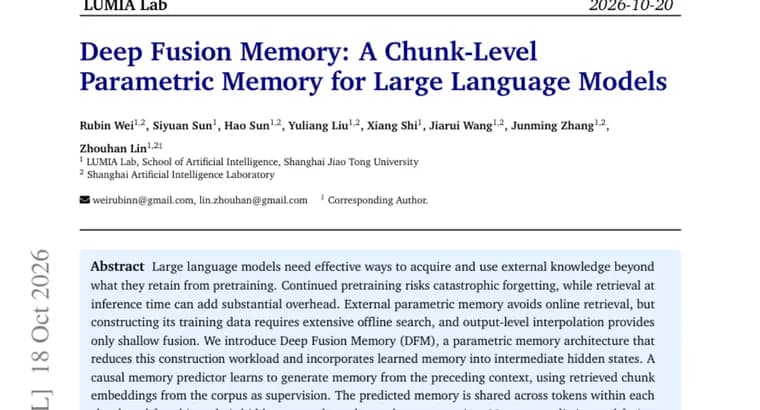
Статья на Hugging Face Papers вводит Deep Fusion Memory (DFM), архитектуру параметрической памяти для больших языковых моделей. Исходная проблема в том, что модели нужно получать и использовать внешние знания сверх тех, что остались от предобучения. По словам авторов аннотации, у существующих способов есть изъяны: дообучение (continued pretraining) рискует катастрофическим забыванием, поиск во время вывода даёт заметные накладные расходы, а внешняя параметрическая память хотя и обходится без онлайн-поиска, но требует для построения обучающих данных обширного офлайн-поиска, а интерполяция на уровне выхода обеспечивает лишь поверхностное слияние.
Устройство DFM. Причинный предсказатель памяти (causal memory predictor) учится генерировать память по предыдущему контексту; в качестве обучающего сигнала используются эмбеддинги фрагментов (chunk), найденные в корпусе. Предсказанная память общая для всех токенов внутри одного фрагмента и подмешивается в их скрытые состояния через перекрёстное внимание с гейтингом (gated cross-attention). Предсказание и слияние памяти обучаются сквозным образом при замороженной основной модели, а при выводе явный поиск не требуется.
Результаты по аннотации. Существующие подходы к параметрической памяти часто строят цели памяти на уровне токенов; DFM для построения обучающих данных требует в 32 раза меньше поисковых запросов и в 2048 раз меньше извлечённых элементов. На шести задачах вопросно-ответного типа DFM превосходит сильнейшую базовую линию на 12,71% на Mistral-7B-v0.3 и на 11,19% на Qwen3-8B-Base. Помимо QA, адаптация к предметным областям даёт средний прирост 6,51 пункта для Qwen3-4B-Base и 4,38 пункта для Qwen3-8B-Base.
Ключевые факты
- DFM предсказывает память для каждого фрагмента текста по предыдущему контексту и сливает её со скрытыми состояниями через перекрёстное внимание с гейтингом; основная модель заморожена.
- При выводе явный поиск не нужен, а офлайн-построение обучающих данных дешевле токенового подхода: в 32 раза меньше поисковых запросов и в 2048 раз меньше извлечённых элементов.
- На шести QA-задачах DFM опережает сильнейшую базовую линию на 12,71% (Mistral-7B-v0.3) и 11,19% (Qwen3-8B-Base).
- Адаптация к предметным областям даёт средний прирост 6,51 пункта для Qwen3-4B-Base и 4,38 пункта для Qwen3-8B-Base.
Почему это важно
Добавить модели знания можно тремя путями, и у каждого есть цена: дообучение грозит забыванием, поиск при выводе замедляет работу, а параметрическая память требует дорогого офлайн-поиска при подготовке данных. DFM претендует на сокращение именно этой последней статьи расходов (в 32 раза меньше запросов и в 2048 раз меньше извлечённых элементов) и при этом обходится без поиска при выводе.
Кому это важно
Исследователям, которые занимаются внешней памятью и пополнением знаний языковых моделей, а также командам, адаптирующим открытые модели к предметной области без дообучения всех весов и без поискового слоя при выводе.
Как это применить
Из аннотации следует схема: заморозить основную модель, обучить предсказатель памяти и блок слияния, а при выводе работать без явного поиска. Результаты приведены для Mistral-7B-v0.3, Qwen3-8B-Base и Qwen3-4B-Base. Для практического применения нужен полный текст статьи: аннотация не называет ни размер фрагмента, ни выпуск кода или моделей.
Можно ли доверять
Это аннотация препринта, все цифры, заявления авторов статьи, независимой проверки в тексте нет. Авторы и организации в аннотации не названы. Не сказано, абсолютный или относительный прирост 12,71% и 11,19% и усреднён ли он по шести задачам; сами задачи, базовые линии и предметные области тоже не названы.
Риски и подводные камни
В аннотации нет данных о задержке при выводе и затратах памяти, поэтому выигрыш по сравнению с подходами с поиском оценить нельзя. Прирост от адаптации к областям приведён только для Qwen3-4B-Base и Qwen3-8B-Base, а результаты на QA, только для Mistral-7B-v0.3 и Qwen3-8B-Base. Сравнение с сильнейшей базовой линией зависит от того, какие базовые линии выбраны, а они не названы.