Представлена ScaleVLA: роботом управляет модель на 552 млрд параметров
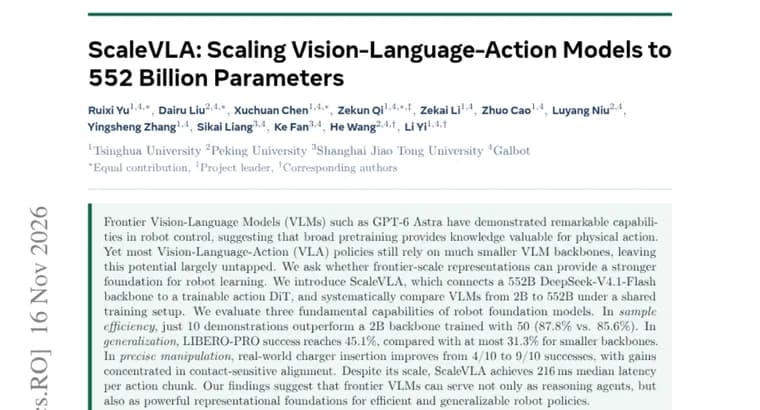
Авторы статьи исходят из наблюдения: передовые визуально-языковые модели (VLM), например GPT-6 Astra, уже показывают впечатляющие способности в управлении роботами, а значит, широкое предобучение даёт знания, полезные для физических действий. При этом большинство моделей класса «зрение, язык, действие» (VLA) по-прежнему опираются на заметно меньшие VLM, и этот потенциал, по мнению авторов, остаётся в основном неиспользованным. Вопрос статьи: может ли представление мира, выученное моделью предельного масштаба, стать более сильной основой для обучения роботов.
Для ответа авторы представили ScaleVLA. Она соединяет опорную модель DeepSeek-V4.1-Flash на 552B параметров с обучаемым модулем action DiT. Затем они систематически сравнили VLM от 2B до 552B параметров в одинаковой схеме обучения и оценили три базовые способности робототехнических фундаментальных моделей.
Первая, эффективность по данным. ScaleVLA, обученная всего на 10 демонстрациях, обошла опорную модель на 2B, обученную на 50: 87,8% против 85,6%. Название метрики в аннотации не указано.
Вторая, обобщение. На LIBERO-PRO успех ScaleVLA достигает 45,1%, тогда как у меньших опорных моделей не выше 31,3%.
Третья, точная манипуляция. В реальной задаче вставки зарядного разъёма результат вырос с 4 успешных попыток из 10 до 9 из 10; по словам авторов, выигрыш сосредоточен в контактно-чувствительном выравнивании. С какой именно конфигурацией сравнивались 4 из 10, в аннотации не сказано.
Несмотря на масштаб, ScaleVLA показывает медианную задержку 216 мс на один блок действий (action chunk). Вывод авторов осторожный: результаты позволяют предположить, что передовые VLM могут служить не только агентами-рассуждателями, но и сильной репрезентационной основой для эффективных и обобщающихся робототехнических политик.
Ключевые факты
- ScaleVLA соединяет опорную модель DeepSeek-V4.1-Flash на 552B параметров с обучаемым модулем action DiT; в сравнении участвовали VLM от 2B до 552B в одинаковой схеме обучения.
- Эффективность по данным: 10 демонстраций у ScaleVLA дают 87,8% против 85,6% у модели на 2B, обученной на 50 демонстрациях (метрика в аннотации не названа).
- Обобщение: на LIBERO-PRO успех 45,1% против не более 31,3% у меньших опорных моделей.
- Реальная вставка зарядного разъёма: с 4/10 до 9/10 успешных попыток, выигрыш сосредоточен в контактно-чувствительном выравнивании.
- Медианная задержка на блок действий, 216 мс; авторы лишь «предполагают», что передовые VLM годятся как основа для робототехнических политик.
Почему это важно
Большинство моделей VLA строят на сравнительно небольших VLM, а передовые модели используют в основном как «мозг-рассуждатель». Здесь проверяют другой путь: взять модель предельного масштаба (552B) как основу для управления движением. Если результаты подтвердятся, это довод в пользу того, что знания, накопленные при широком предобучении, переносятся на физические действия, а число нужных демонстраций можно сократить.
Кому это важно
Исследователям робототехнических фундаментальных моделей и разработчикам VLA-политик, которые выбирают размер опорной VLM. Также тем, кто следит за тем, насколько большие языковые модели пригодны для физического мира, а не только для текста и рассуждений.
Как это применить
Это научная статья, а не готовый продукт. В аннотации не упомянуты выпуск кода, весов или данных, поэтому воспроизвести результат по ней нельзя. Практический вывод для специалистов: сравнивать опорные модели разных размеров в единой схеме обучения и смотреть не только на успех, но и на задержку, ведь авторы приводят 216 мс на блок действий.
Можно ли доверять
Это препринт на странице Hugging Face; независимой проверки пока нет. Пересказ основан только на аннотации: в ней не названы метрика для сравнения 87,8% и 85,6%, исходная конфигурация для 4/10 во вставке разъёма и оборудование, на котором измерена задержка. Также из аннотации не следует, что 45,1% на LIBERO-PRO, лучший результат вообще: сравнение идёт лишь с меньшими опорными моделями в той же работе. Формулировка вывода у авторов осторожная («предполагают»).
Риски и подводные камни
Реальный эксперимент, одна задача с десятью попытками, поэтому разница 4/10 и 9/10 опирается на малую выборку. Преимущество в 10 против 50 демонстраций выражено 87,8% против 85,6%, то есть небольшим отрывом. Абсолютный результат на LIBERO-PRO (45,1%) остаётся ниже половины. Размер модели в 552B также потребует серьёзных вычислительных ресурсов, а число параметров модуля action DiT в аннотации не раскрыто.
«Наши результаты позволяют предположить, что передовые VLM могут служить не только агентами-рассуждателями, но и мощной репрезентационной основой для эффективных и обобщающихся политик управления роботами.»
— Авторы статьи о ScaleVLA, аннотация на Hugging Face