Представлена модель Sage S1.5 Flash на 320 млрд параметров для науки и агентов
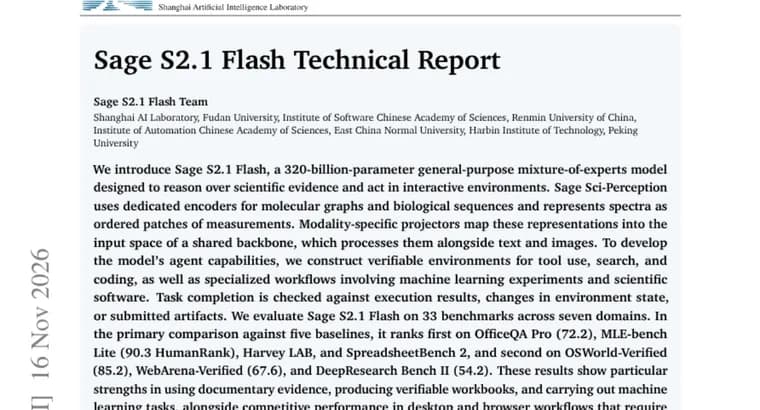
На странице Hugging Face Papers опубликован технический отчёт, озаглавленный «Sage S2.1 Flash Technical Report». В самом тексте аннотации модель называется иначе: Sage S1.5 Flash. Чем объясняется расхождение в номере версии, не сказано, поэтому ниже используется название из аннотации.
Авторы описывают Sage S1.5 Flash как универсальную модель типа «смесь экспертов» (MoE, mixture-of-experts) на 320 млрд параметров. Она предназначена для рассуждений над научными данными и для действий в интерактивных средах. Число активных параметров на токен в аннотации не указано.
Архитектурная особенность: компонент Sage Sci-Perception использует отдельные кодировщики (энкодеры) для молекулярных графов и биологических последовательностей, а спектры представляет как упорядоченные «патчи» (фрагменты) измерений. Модально-специфичные проекторы переводят эти представления во входное пространство общей базовой сети (shared backbone), которая обрабатывает их вместе с текстом и изображениями.
Для агентных способностей авторы создали проверяемые среды для работы с инструментами, поиска и программирования, а также специализированные рабочие процессы с экспериментами по машинному обучению и научным программным обеспечением. Выполнение задачи проверяется по результатам исполнения, изменениям состояния среды или сданным артефактам.
Оценка проведена на 33 бенчмарках из семи областей. В основном сравнении с пятью базовыми моделями Sage S1.5 Flash занимает первое место на OfficeQA Pro (72,2), MLE-bench Lite (90,3 по метрике HumanRank), Harvey LAB и SpreadsheetBench2. Второе место она занимает на OSWorld-Verified (85,2), WebArena-Verified (67,6) и DeepResearch BenchII (54,2). Результаты по Harvey LAB и SpreadsheetBench~2 в аннотации числами не приведены.
Итог, как его формулируют авторы: особенно сильны использование документальных свидетельств, подготовка проверяемых рабочих таблиц и выполнение задач по машинному обучению; в сценариях работы с рабочим столом и браузером, где нужно действовать по визуальной обратной связи, модель показывает конкурентный, но не лидирующий результат.
Ключевые факты
- Sage S1.5 Flash: универсальная модель типа «смесь экспертов» на 320 млрд параметров для рассуждений над научными данными и действий в интерактивных средах; на странице статьи она названа S2.1, в аннотации, S1.5.
- Для научных данных используются отдельные кодировщики молекулярных графов и биологических последовательностей; спектры подаются как упорядоченные патчи измерений, а проекторы передают всё в общую базовую сеть вместе с текстом и изображениями.
- Оценка на 33 бенчмарках из семи областей; в основном сравнении с пятью базовыми моделями, первое место на четырёх (OfficeQA Pro 72,2; MLE-bench Lite 90,3 HumanRank; Harvey LAB; SpreadsheetBench~2) и второе на трёх.
- Второе место: OSWorld-Verified (85,2), WebArena-Verified (67,6), DeepResearch Bench~II (54,2); в работе с рабочим столом и браузером результат авторы называют конкурентным.
- Агентные навыки обучали в проверяемых средах: задача засчитывается по результатам исполнения, изменению состояния среды или сданным артефактам.
Почему это важно
Отчёт описывает крупную модель типа «смесь экспертов», в которую научные данные (молекулы, биологические последовательности, спектры) встроены как отдельные виды входа, а не пересказаны текстом. Одновременно авторы делают упор на агентную работу: таблицы, задачи по машинному обучению, офисные задачи, управление компьютером и браузером. Заявлено первое место на четырёх и второе на трёх бенчмарках из основного сравнения с пятью базовыми моделями. Это заявление самих авторов, а не независимая оценка.
Кому это важно
Исследователям, которые следят за моделями для науки и химико-биологических данных, и тем, кто строит агентов для работы с документами, таблицами и экспериментами по машинному обучению. Практикам, выбирающим модель для автоматизации работы с рабочим столом и браузером, стоит учесть: здесь авторы говорят лишь о конкурентном результате, второе место на OSWorld-Verified, WebArena-Verified и DeepResearch Bench~II.
Как это применить
По аннотации применить нечего: в ней не указаны доступность весов, лицензия, цена и способ доступа к модели. Практический шаг сейчас один: открыть полный текст отчёта и проверить, какие базовые модели сравнивались и по каким метрикам, прежде чем делать выводы о превосходстве над конкретными конкурентами.
Можно ли доверять
Все цифры и выводы принадлежат самим авторам отчёта; независимой проверки в тексте нет. Кто стоит за Sage (авторы, организация), аннотация не называет. Название модели в заголовке страницы (S2.1) не совпадает с названием в тексте (S1.5), и объяснения этому нет. Не названы пять базовых моделей и остальные 26 бенчмарков из 33, не перечислены семь областей, не раскрыты оценки базовых моделей. Для OfficeQA Pro, OSWorld-Verified, WebArena-Verified и DeepResearch Bench~II единицы измерения не указаны, подписана только метрика MLE-bench Lite (HumanRank).
Риски и подводные камни
Заявленные первые и вторые места относятся только к основному сравнению с пятью базовыми моделями, состав которых неизвестен; на остальных бенчмарках результат не раскрыт. Для Harvey LAB и SpreadsheetBench~2 даже собственные баллы модели не приведены. Числа активных параметров на токен нет, поэтому реальную стоимость запуска по одной цифре в 320 млрд оценить нельзя. Путаница в названии версии (S1.5 или S2.1) затрудняет поиск и сопоставление с другими материалами.