Представлен RLE-Bench: бенчмарк для кодинг-агентов в робототехнике
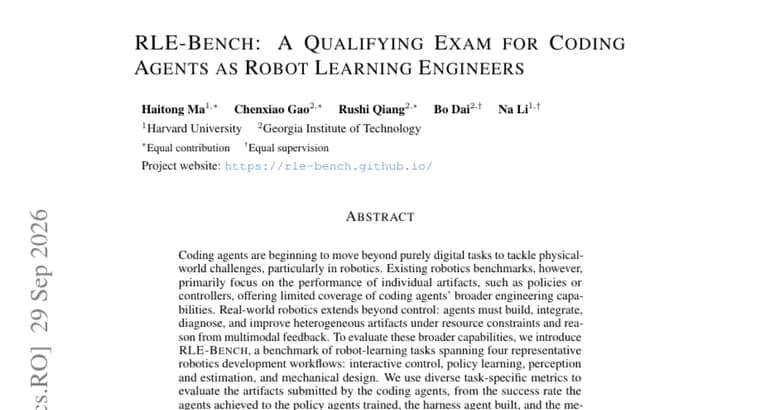
Авторы статьи отмечают, что кодинг-агенты начинают выходить за рамки чисто цифровых задач и браться за задачи физического мира, прежде всего в робототехнике. Но существующие робототехнические бенчмарки, по их словам, в основном оценивают отдельные артефакты, например политики или контроллеры, и слабо охватывают более широкие инженерные способности агентов.
Между тем реальная робототехника не сводится к управлению: агенту нужно создавать, интегрировать, диагностировать и улучшать разнородные артефакты в условиях ограниченных ресурсов и делать выводы из мультимодальной обратной связи. Чтобы проверить эти способности, авторы представляют RLE-Bench, набор задач по обучению роботов (robot learning), охватывающий четыре типичных рабочих процесса разработки в робототехнике: интерактивное управление, обучение политик, восприятие и оценку состояния (perception and estimation) и механическое проектирование.
Оценивается то, что агент в итоге сдаёт. Метрики зависят от задачи: от достигнутой доли успеха до обученной агентом политики, написанной им обвязки (harness) и спроектированных им механических конструкций. Метрики сводятся в общий индекс RLE Index, а также в профили способностей по каждому из четырёх рабочих процессов, это позволяет систематически сравнивать кодинг-агентов по нескольким измерениям.
Помимо рейтинга по результатам, авторы провели подробные разборы поведения агентов на репрезентативных задачах. Они показывают текущие возможности и ограничения агентов и указывают, какие возможности робототехнические задачи дают для будущего обучения агентов. В доступном тексте аннотации нет конкретных результатов: не приведены оценки, значения RLE Index и рейтинги агентов или моделей, не названы проверенные агенты и не указано число задач.
Ключевые факты
- RLE-Bench, бенчмарк задач по обучению роботов для оценки кодинг-агентов как инженеров, а не только исполнителей отдельных задач.
- Охватывает четыре рабочих процесса: интерактивное управление, обучение политик, восприятие и оценку, механическое проектирование.
- Оцениваются сданные агентом артефакты: достигнутая доля успеха, обученные политики, написанная обвязка, спроектированные механические конструкции.
- Метрики сводятся в общий RLE Index и профили способностей по каждому рабочему процессу; добавлены разборы поведения агентов на отдельных задачах.
- В тексте аннотации нет численных результатов, списка проверенных агентов и числа задач.
Почему это важно
Кодинг-агенты всё чаще выходят из чисто цифровой среды в физический мир, а существующие робототехнические бенчмарки, по утверждению авторов, оценивают в основном отдельные артефакты вроде политик или контроллеров. RLE-Bench предлагает мерить более широкий круг инженерных навыков: сборку, интеграцию, диагностику и улучшение разнородных артефактов при ограниченных ресурсах и с опорой на мультимодальную обратную связь.
Кому это важно
Исследователям и разработчикам кодинг-агентов, которым нужен способ сравнивать агентов за пределами программных задач, а также командам, которые занимаются робототехникой и обучением роботов и хотят понять, насколько агенты пригодны для их рабочих процессов. Для массового читателя материал пока слишком специализирован.
Как это применить
Из доступного текста видно только устройство бенчмарка: четыре рабочих процесса, метрики под каждую задачу, общий RLE Index и профили способностей по процессам. Какие агенты и модели можно на нём прогнать, как запустить задачи и опубликованы ли код, данные или таблица лидеров, в тексте не сказано, поэтому за практическими деталями нужно смотреть саму статью.
Можно ли доверять
Это описание бенчмарка в аннотации научной статьи, заявления принадлежат самим авторам. Конкретных результатов, оценок агентов и числа задач в тексте нет, так что проверить заявленную полезность индекса по этому материалу нельзя. Не указано и то, выполняются ли задачи в симуляции или на реальных роботах.
Риски и подводные камни
Сведение многих разнородных метрик в один индекс RLE Index упрощает сравнение, но может скрывать различия между рабочими процессами; поэтому авторы дополнительно приводят профили способностей. Конкретные ограничения агентов, найденные в разборах, в тексте не описаны. Пока не опубликованы результаты, оценивать, насколько бенчмарк различает агентов, преждевременно.
«Кодинговые агенты начинают выходить за рамки чисто цифровых задач и браться за вызовы физического мира, особенно в робототехнике.»
— из аннотации статьи об RLE-Bench