ScholarCatalyst: бенчмарк показал, что ИИ-агенты плохо находят вдохновляющие статьи
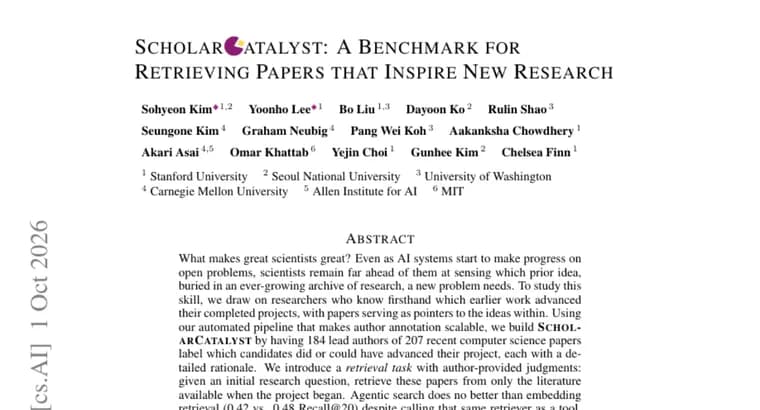
Авторы работы исходят из наблюдения: даже когда ИИ-системы начинают продвигаться в открытых задачах, учёные заметно лучше чувствуют, какая именно прежняя идея из растущего архива исследований нужна новой задаче. Чтобы изучить этот навык, они опираются на тех, кто знает из первых рук, какие более ранние работы продвинули их завершённые проекты. Статьи при этом служат указателями на идеи внутри них.
С помощью автоматизированного конвейера, который делает разметку силами авторов масштабируемой, они построили ScholarCatalyst. 184 ведущих автора 207 недавних статей по computer science (информатике) отметили, какие из предложенных кандидатов продвинули или могли бы продвинуть их проект, и к каждой отметке дали подробное обоснование.
На этих данных сформулирована задача поиска: по исходному исследовательскому вопросу найти эти статьи, имея доступ только к литературе, которая существовала к началу проекта.
Результаты скромные. Агентный поиск не лучше поиска по эмбеддингам: 0,42 против 0,48 Recall@20, хотя агент вызывает тот же самый поисковик как инструмент. Даже агент на основе Claude Fable 5.1, который мог видеть готовые статьи во время обучения, достигает лишь 0,51 R@20. Авторы делают вывод, что нужны новые рецепты обучения, которые дадут моделям экспертную интуицию для поиска по обширным корпусам, и видят в ScholarCatalyst шаг к научным агентам, способным взять недоопределённую идею и указать на нужные для неё прежние исследования.
Ключевые факты
- ScholarCatalyst построен по разметке 184 ведущих авторов 207 недавних статей по computer science: они отмечали кандидатов, которые продвинули или могли продвинуть их проект, с подробным обоснованием.
- Задача: по исходному исследовательскому вопросу найти эти статьи, используя только литературу, доступную к началу проекта.
- Агентный поиск не превзошёл поиск по эмбеддингам: 0,42 против 0,48 Recall@20, хотя агент вызывает тот же поисковик как инструмент.
- Агент на основе Claude Fable 5.1, который мог видеть готовые статьи при обучении, достиг только 0,51 R@20.
- Авторы призывают к новым рецептам обучения, дающим моделям экспертную интуицию при поиске по широким корпусам.
Почему это важно
Поиск нужных прежних работ под новую задачу, один из навыков, которых ждут от научных ИИ-агентов. Бенчмарк измеряет его на реальных оценках людей, знающих свои проекты изнутри, а не на косвенных признаках вроде цитирований. По словам авторов, учёные пока далеко впереди ИИ в умении почувствовать, какая идея из огромного архива нужна новой задаче. Цифры показывают разрыв: даже лучший из названных результатов, 0,51 R@20.
Кому это важно
Исследователям, которые создают поисковых и научных агентов и системы поиска литературы, а также авторам бенчмарков для оценки научных способностей моделей. Заметна и общая мысль для тех, кто строит агентов поверх поиска: добавление агентной надстройки над тем же поисковиком в этом тесте не дало выигрыша.
Как это применить
Это исследовательский бенчмарк, а не готовый продукт. В источнике нет сведений о выпуске данных или кода. Практический вывод для разработчиков: сравнивать агентный поиск с обычным поиском по эмбеддингам на задаче «найти идею, которая нужна проекту», а не только на задаче «найти релевантный текст», и учитывать, что агент вызывает тот же поисковик как инструмент.
Можно ли доверять
Источник, аннотация работы, и все выводы принадлежат её авторам. Сильная сторона замысла, разметка силами ведущих авторов статей с подробными обоснованиями. Агент на Claude Fable 5.1 мог видеть завершённые статьи при обучении, и авторы сами отмечают это; при этом он получил лишь 0,51 R@20. Из аннотации не видно, какие ещё агенты и какой поисковик по эмбеддингам тестировались, так что полную картину нужно смотреть в самой работе.
Риски и подводные камни
Цифры 0,42, 0,48 и 0,51 нельзя прямо сравнивать между собой без деталей постановки: аннотация не раскрывает, использовал ли агент на Claude Fable 5.1 тот же поисковик. Кроме того, разметка отражает мнения конкретных авторов о том, что продвинуло или могло продвинуть их проект, а набор охватывает недавние статьи по computer science, поэтому переносить выводы на другие области нужно осторожно.