Parallel Power Tempering: рассуждения нейросетей без RL-дообучения
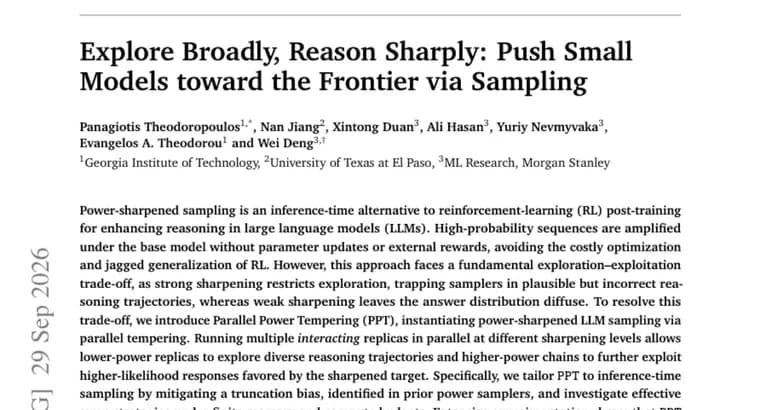
В статье с портала Hugging Face Papers рассматривается так называемая power-sharpened выборка (степенное «заострение» распределения), способ усилить рассуждения больших языковых моделей (LLM) на этапе вывода, а не через дообучение с подкреплением (RL). Идея в том, что последовательности с высокой вероятностью по базовой модели усиливаются без обновления параметров и без внешних вознаграждений. Авторы считают, что так удаётся избежать дорогой оптимизации и «неровной» обобщаемости, характерных для RL.\n\nУ подхода есть фундаментальная проблема баланса между исследованием и использованием уже найденного. Сильное заострение ограничивает исследование и заводит сэмплер в правдоподобные, но неверные цепочки рассуждений. Слабое заострение оставляет распределение ответов размытым.\n\nЧтобы разрешить этот компромисс, авторы вводят Parallel Power Tempering (PPT), реализацию степенной выборки через параллельное темперирование (parallel tempering). Несколько взаимодействующих реплик запускаются параллельно при разных уровнях заострения: реплики с меньшей степенью исследуют разнообразные траектории рассуждения, а цепочки с большей степенью дальше используют ответы с более высокой вероятностью, которые предпочитает заострённая целевая модель.\n\nЧтобы приспособить метод к выборке на этапе вывода, авторы устраняют смещение усечения (truncation bias), которое они обнаружили в прежних степенных сэмплерах, и изучают эффективные стратегии обмена между репликами при ограниченных памяти и вычислениях.\n\nПо словам авторов, обширные эксперименты показывают: PPT существенно улучшает одноцепочечную степенную выборку, превосходит модели, прошедшие RL-дообучение, даёт более качественные цепочки рассуждений и даже достигает результатов, сопоставимых с передовыми моделями. Названий бенчмарков, конкретных чисел, используемых моделей и затрат вычислений в тексте аннотации нет.
Ключевые факты
- PPT (Parallel Power Tempering), метод выборки на этапе вывода: рассуждения улучшаются без обновления параметров модели и без внешних вознаграждений.
- Несколько взаимодействующих реплик работают параллельно при разных уровнях заострения: слабее заострённые исследуют разные траектории, сильнее заострённые используют более вероятные ответы.
- Метод устраняет смещение усечения, выявленное авторами в прежних степенных сэмплерах, и подбирает стратегии обмена между репликами при ограниченных памяти и вычислениях.
- По заявлению авторов, PPT существенно улучшает одноцепочечную степенную выборку и превосходит модели после RL-дообучения, а по качеству приближается к передовым моделям.
Почему это важно
RL-дообучение, основной способ усилить рассуждения языковых моделей, но авторы называют его дорогой оптимизацией с «неровной» обобщаемостью. PPT предлагает альтернативу на этапе вывода: базовая модель остаётся неизменной, а качество рассуждений растёт за счёт более умной выборки. Если заявленные результаты подтвердятся, это снижает зависимость от дорогого пост-обучения.
Кому это важно
Исследователям рассуждений и выборки из языковых моделей, командам, которые не могут позволить себе RL-дообучение, и тем, кто работает с вычислениями на этапе вывода. Для широкого читателя это пока скорее сигнал о направлении исследований, чем готовый продукт.
Как это применить
Практических инструкций в тексте нет: код и его доступность не упоминаются. Идея для разработчиков такая: вместо одной цепочки с фиксированной степенью заострения запускать несколько реплик с разными степенями и обмениваться состояниями между ними, исправив смещение усечения. Какое число реплик нужно и во что это обходится по вычислениям, из текста узнать нельзя.
Можно ли доверять
Все выводы, заявления самих авторов в аннотации. Конкретных чисел, названий бенчмарков, базовых и сравниваемых моделей (RL-дообученных и передовых) в ней нет, поэтому проверить фразы «превосходит» и «сопоставимо с передовыми моделями» по тексту нельзя. Нужно читать полную статью.
Риски и подводные камни
Дополнительные вычисления на этапе вывода (несколько реплик, обмены между ними) могут оказаться заметными, но их размер в аннотации не указан, поэтому выигрыш относительно RL или одноцепочечной выборки по затратам оценить нельзя. Сам авторы отмечают риск метода степенной выборки: слишком сильное заострение загоняет сэмплер в правдоподобные, но неверные рассуждения.