Представлен бенчмарк LongBanana для синтеза изображений по множеству референсов
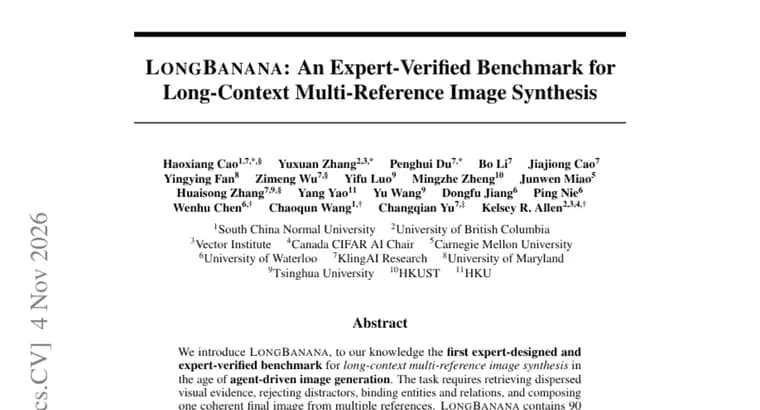
В препринте на Hugging Face представлен LongBanana, по утверждению авторов, первый бенчмарк для синтеза изображений по длинному контексту из множества референсов, который разработан и проверен экспертами. Он рассчитан на эпоху генерации изображений с помощью агентов.
Задача устроена так: нужно найти в большом наборе картинок разрозненные визуальные свидетельства, отсеять отвлекающие изображения, правильно связать сущности и отношения между ними и собрать из нескольких референсов одно целостное итоговое изображение.
В бенчмарке 90 тщательно подготовленных задач, организованных по таксономии «3 на 3». На каждую задачу приходится примерно 32 референсных изображения, 20 ограничений и 50 пунктов оценки; всего получилось 4670 атомарных пунктов оценки, заданных экспертами.
Оценка построена на графах. Каждая задача сопровождается референсами и графом сущностей и связей, а требования к узлам, рёбрам и графу в целом превращаются в чек-лист по трём критериям: верность содержанию (Content Fidelity), привязка отношений (Relational Binding) и выполнение глобальных ограничений (Global Constraint Satisfaction).
О качестве разметки сказано так: в проверенных экспертных метках есть подмножество в 15% с двойной разметкой, на нём точное совпадение составило 89,4%, а квадратично взвешенная каппа, 0,83.
Кроме бенчмарка авторы вводят LongBanana-Gen, агентную обвязку (harness) для долгой многошаговой генерации изображений. По их словам, минимальные агентные обвязки улучшают результат по сравнению с прямой генерацией, а рабочий процесс ReAct-Plan-Exec-Reflect (RPR) даёт выигрыш, зависящий от обвязки, за счёт более надёжной опоры на свидетельства и исправления ошибок. Итог по мысли авторов: LongBanana, проверяемый полигон для измерения того, насколько плотно система использует визуальные свидетельства, и общая цель для разработки более сильных агентных систем генерации. Код и данные доступны на странице проекта long-banana.com.
Ключевые факты
- LongBanana, по утверждению авторов, первый бенчмарк синтеза изображений по длинному контексту из множества референсов, разработанный и проверенный экспертами.
- 90 задач по таксономии «3 на 3»; на задачу примерно 32 референса, 20 ограничений и 50 пунктов оценки; всего 4670 экспертных атомарных пунктов оценки.
- Оценка опирается на граф сущностей и связей и чек-лист по трём критериям: верность содержанию, привязка отношений, выполнение глобальных ограничений.
- На подмножестве с двойной разметкой (15% меток) точное совпадение 89,4%, квадратично взвешенная каппа 0,83.
- LongBanana-Gen, агентная обвязка; по заявлению авторов, минимальные обвязки лучше прямой генерации, а процесс ReAct-Plan-Exec-Reflect (RPR) даёт выигрыш, зависящий от обвязки.
Почему это важно
Генерация изображений всё чаще строится вокруг агентов, которым нужно работать с большим числом входных картинок, а не с одной подсказкой. LongBanana нацелен именно на такой сценарий: найти нужное среди разрозненных референсов, не поддаться отвлекающим изображениям и собрать единый результат. По словам авторов, это проверяемый полигон для измерения плотного использования визуальных свидетельств.
Кому это важно
Исследователям генерации изображений и разработчикам агентных систем, которым нужен способ сравнивать подходы на длинном мультимодальном контексте. Интерес нишевый: это препринт без громких имён в аннотации, но с открытыми кодом и данными.
Как это применить
Код и данные, по словам авторов, доступны на странице проекта long-banana.com. Бенчмарк можно использовать как общую мишень для сравнения агентных обвязок и процессов вроде RPR; условия лицензии в аннотации не указаны.
Можно ли доверять
Это препринт: заявление о «первом» бенчмарке принадлежит самим авторам («насколько им известно»). Показатели согласованности разметки (89,4% точного совпадения, каппа 0,83) приведены для 15% меток с двойной разметкой, а не для всего набора. Названия протестированных моделей и размеры выигрыша агентных обвязок в аннотации не приведены, так что утверждения об улучшении по ней проверить нельзя.
Риски и подводные камни
Бенчмарк небольшой: 90 задач, хотя пунктов оценки много. Примерные цифры на задачу (около 32 референсов, 20 ограничений, 50 пунктов) в аннотации не сведены с итогом 4670. Содержание таксономии «3 на 3», число и набор экспертов в аннотации не описаны. Выводы про выигрыш от RPR заявлены как зависящие от обвязки, то есть переносить их на другие системы без проверки нельзя.