Правка весов Qwen3.5 агентами: 1023 параметра дали до +29,45 п.п. на MATH-500
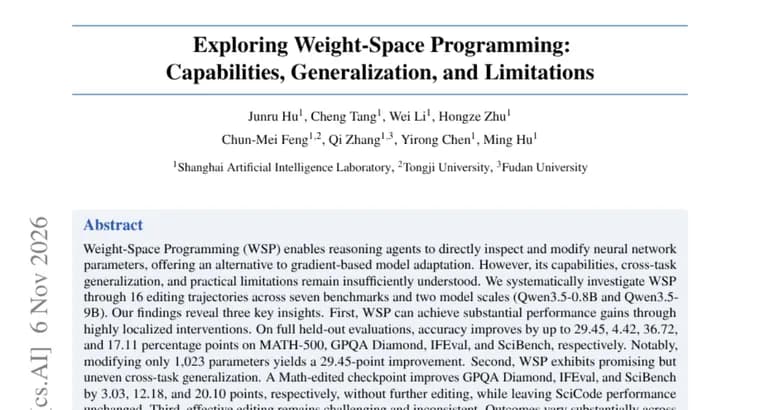
Статья с Hugging Face Papers систематически исследует Weight-Space Programming (WSP, «программирование в пространстве весов»). Суть подхода: рассуждающие агенты напрямую просматривают и изменяют параметры нейросети, а не адаптируют модель градиентными методами. По словам авторов, возможности, перенос между задачами и практические ограничения такого подхода были изучены недостаточно.
Эксперимент: 16 траекторий редактирования на семи бенчмарках и двух масштабах модели, Qwen3.5-0.8B и Qwen3.5-9B. Авторы формулируют три вывода.
Первый: существенный прирост можно получить очень локальными вмешательствами. На полной отложенной выборке точность выросла на величину до 29,45 п.п. на MATH-500, до 4,42 п.п. на GPQA Diamond, до 36,72 п.п. на IFEval и до 17,11 п.п. на SciBench. Отдельно отмечено, что изменение всего 1023 параметров даёт прирост в 29,45 п.п.
Второй: перенос между задачами многообещающий, но неравномерный. Чекпойнт, отредактированный на математике, без дополнительных правок улучшил GPQA Diamond на 3,03 п.п., IFEval на 12,18 п.п. и SciBench на 20,10 п.п. А вот результат на SciCode остался прежним.
Третий: эффективное редактирование остаётся трудным и нестабильным. Результаты заметно различаются от траектории к траектории, а в шести из 16 траекторий исходные веса сохранены, потому что кандидатные улучшения не удалось надёжно подтвердить.
Итог авторов: WSP перспективен для очень локальной адаптации моделей, но остаются серьёзные проблемы с поиском нужных вмешательств, надёжностью и переносом между задачами. Есть страница проекта (wsp-scope.github.io) и репозиторий на GitHub (WSP-Scope/WSP-Scope-Project).
Ключевые факты
- WSP: агенты напрямую читают и правят параметры нейросети, альтернатива градиентной адаптации; изучено на 16 траекториях редактирования, 7 бенчмарках и двух моделях (Qwen3.5-0.8B и Qwen3.5-9B).
- Прирост точности на отложенной выборке, до 29,45 п.п. (MATH-500), 4,42 (GPQA Diamond), 36,72 (IFEval) и 17,11 (SciBench); это максимумы по траекториям, а не средние.
- Правка всего 1023 параметров дала прирост 29,45 п.п.
- Math-чекпойнт без дополнительных правок улучшил GPQA Diamond на 3,03, IFEval на 12,18 и SciBench на 20,10 п.п., но SciCode не изменился.
- Результаты нестабильны: в шести из 16 траекторий исходные веса оставлены, так как улучшения не удалось надёжно подтвердить.
Почему это важно
Обычно модель адаптируют градиентным дообучением. Здесь проверяют другую идею: агент сам находит и меняет небольшой набор весов. Работа показывает, что такой путь способен дать большой прирост на отдельных задачах при крайне малом числе изменённых параметров (1023 в самом ярком случае), и одновременно фиксирует границы подхода: перенос на другие задачи неровный, а надёжность низкая.
Кому это важно
Исследователям адаптации моделей и интерпретируемости, а также тем, кто изучает альтернативы дообучению и автоматизированное редактирование моделей агентами. Для практиков, которым нужен готовый рабочий метод, это скорее постановка вопроса и карта проблем, чем рецепт.
Как это применить
Прямого руководства в пересказе нет. Авторы указывают страницу проекта (wsp-scope.github.io) и репозиторий на GitHub (WSP-Scope/WSP-Scope-Project); что именно в них лежит, источник не описывает. Осмысленный шаг для заинтересованных, посмотреть материалы проекта и воспроизвести эксперимент на малой модели, учитывая нестабильность исходов.
Можно ли доверять
Это результаты авторов статьи в виде аннотации на Hugging Face Papers; независимой проверки в тексте нет. Приведённые приросты, максимумы по траекториям, средние и медианные значения не указаны. Базовые значения точности не названы, поэтому перевести приросты в итоговые баллы нельзя. Не указано и то, какой из двух масштабов модели дал каждый результат, включая 29,45 п.п. при 1023 параметрах.
Риски и подводные камни
Не стоит читать «до +36,72 п.п.» как типичный результат: это лучший случай, а исходы сильно различаются между траекториями. В шести из 16 траекторий улучшения не удалось надёжно подтвердить, и исходные веса остались. Перенос между задачами неравномерен: Math-чекпойнт помог на трёх бенчмарках, но не изменил SciCode. Сравнения с градиентным дообучением по стоимости или качеству в источнике нет, поэтому утверждать преимущество WSP над ним нельзя.