Предложен WildAWM: открытые модели создают среды для ИИ-агентов
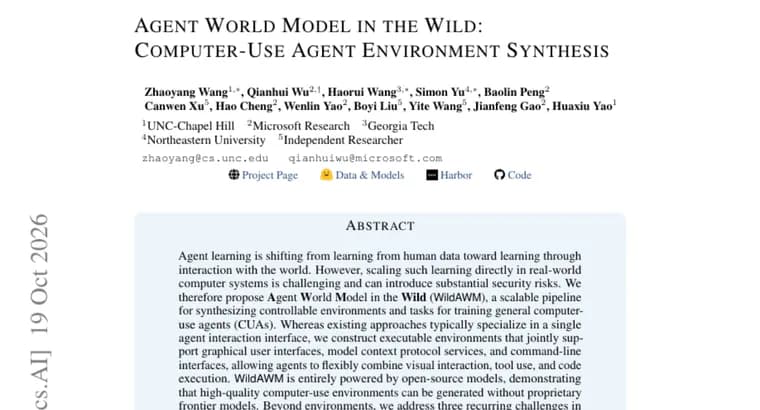
Авторы препринта исходят из того, что обучение агентов смещается от человеческих данных к обучению через взаимодействие с миром. Но масштабировать такое обучение прямо в реальных компьютерных системах сложно, и это может создавать серьёзные риски для безопасности. Поэтому они предлагают Agent World Model in the Wild (WildAWM), масштабируемый конвейер, который синтезирует управляемые среды и задачи для обучения универсальных агентов, работающих с компьютером (computer-use agents, CUA).
Существующие подходы, как правило, специализируются на одном интерфейсе взаимодействия. WildAWM строит исполняемые среды, которые одновременно поддерживают графические интерфейсы (GUI), сервисы на основе протокола model context protocol (MCP) и командную строку. Благодаря этому агент может гибко сочетать визуальное взаимодействие, использование инструментов и выполнение кода. Весь конвейер работает на открытых моделях; по словам авторов, это показывает, что качественные среды для работы с компьютером можно генерировать без закрытых передовых моделей.
Отдельно авторы решают три повторяющиеся проблемы синтеза задач: чтобы задача была решаема, достаточно сложна и имела надёжные проверяющие механизмы (верификаторы). Для этого введены «ворота качества» на основе исполнения, которые сочетают прогоны разнородных агентов, проверки согласованности между разными судьями и контрфактические пробы устойчивости оценок.
В итоге конвейер синтезирует 341 длинную пару «среда, задача». Некоторым из них для решения может потребоваться более 100 шагов агента. Задачи остаются трудными даже для передовых моделей: GPT-6-Astra решает лишь 60% из них.
Затем авторы обучили две модели Qwen разных размеров исключительно в этих синтетических мирах. Обе показали существенный прирост на 8 внешних (out-of-distribution) тестах, охватывающих web-, claw- и computer-use-агентов. Авторы делают вывод, что обучение в синтезированных WildAWM мирах широко обобщается на незнакомые задачи по работе с компьютером. Код опубликован на GitHub.
Ключевые факты
- WildAWM, конвейер на открытых моделях, который синтезирует исполняемые среды и задачи для обучения агентов, работающих с компьютером.
- Среды одновременно поддерживают графический интерфейс, сервисы MCP и командную строку, в отличие от подходов под один интерфейс.
- Получено 341 длинная пара «среда, задача»; некоторым нужно более 100 шагов агента, а GPT-6-Astra решает лишь 60% из них.
- Две модели Qwen разных размеров, обученные только в синтетических мирах, улучшили результаты на 8 внешних тестах.
- Код опубликован: github.com/MSR-Orchard/WildAWM.
Почему это важно
Обучать агентов прямо в реальных компьютерных системах трудно и небезопасно, поэтому синтетические среды, способ масштабировать такое обучение. Особенность WildAWM, по заявлению авторов, в том, что среды охватывают сразу три интерфейса (GUI, MCP, командная строка) и создаются целиком на открытых моделях, без закрытых передовых.
Кому это важно
Исследователям и командам, которые обучают агентов для работы с компьютером и веб-задачами и хотят обойтись без дорогих закрытых моделей при построении обучающих сред. Также тем, кто занимается проверкой качества синтетических задач и надёжностью верификаторов.
Как это применить
Код доступен публично на GitHub (MSR-Orchard/WildAWM), так что конвейер можно изучить и попробовать воспроизвести. Лицензия, стоимость обучения и требования к вычислительным ресурсам в источнике не указаны, поэтому оценивать затраты заранее нельзя.
Можно ли доверять
Это препринт: все выводы о широком обобщении и о том, что открытые модели достаточны для создания сред, принадлежат самим авторам. В аннотации нет значений по отдельным тестам, величины прироста и базовых результатов для моделей Qwen, а размеры и версии этих моделей не названы. Поэтому масштаб улучшения проверить по аннотации нельзя; для оценки нужны полный текст статьи и код.
Риски и подводные камни
Цифра 60% относится к опорной модели GPT-6-Astra на 341 синтезированной паре, а не к сравнению с обученными Qwen. Фраза «более 100 шагов» означает лишь, что так может быть для части задач, а не типичную длину. Прирост на внешних тестах пока описан качественно («существенный»), без чисел, поэтому делать выводы о практической пользе для реальных рабочих задач рано.