Предложен Self-Credit: ИИ-агент сам распределяет заслуги за шаги при обучении с подкреплением
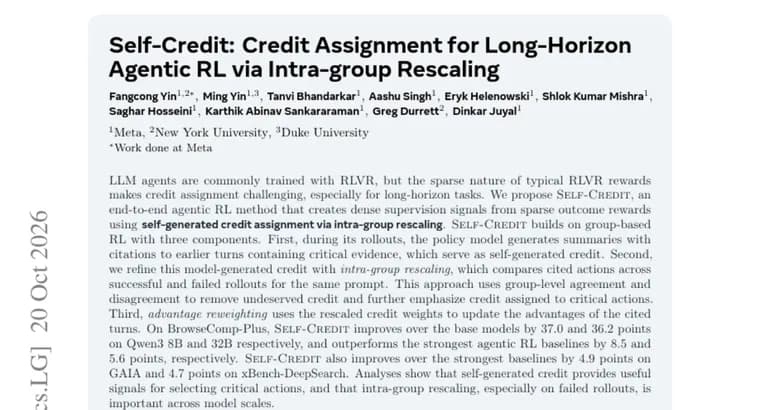
В статье на Hugging Face предложен Self-Credit, сквозной метод обучения с подкреплением для ИИ-агентов на основе больших языковых моделей. Исходная проблема: агентов обычно обучают с помощью RLVR (обучения с подкреплением с проверяемыми наградами), но такие награды редкие, они приходят лишь по итогу задачи. Из-за этого трудно понять, какие именно шаги привели к успеху, особенно в длинных задачах, где агент делает много ходов (так называемое распределение заслуг, credit assignment).
Self-Credit превращает редкую итоговую награду в плотные обучающие сигналы за счёт заслуг, которые модель назначает себе сама, и их уточнения внутри группы попыток. Метод опирается на групповое обучение с подкреплением и состоит из трёх частей.
Первая: во время прогонов (rollouts) обучаемая модель пишет краткие сводки со ссылками на более ранние ходы, где содержатся ключевые свидетельства. Эти ссылки и служат самосгенерированной оценкой заслуг.
Вторая: эту оценку уточняет внутригрупповое масштабирование (intra-group rescaling). Оно сравнивает процитированные действия в удачных и неудачных попытках для одного и того же запроса. Согласие и расхождение внутри группы помогают убрать незаслуженные заслуги и усилить те, что приписаны действительно ключевым действиям.
Третья: переоценка преимуществ (advantage reweighting) использует полученные веса, чтобы обновить преимущества именно процитированных ходов.
Результаты по данным аннотации. На BrowseComp-Plus Self-Credit улучшает базовые модели на 37,0 пункта (Qwen3 8B) и 36,2 пункта (Qwen3 32B), а сильнейшие базовые методы агентного обучения с подкреплением обходит на 8,5 и 5,6 пункта соответственно. Кроме того, он опережает сильнейшие базовые методы на 4,9 пункта на GAIA и на 4,7 пункта на xBench-DeepSearch. Анализ, по словам авторов, показывает, что самосгенерированные заслуги дают полезные сигналы для выбора ключевых действий, а внутригрупповое масштабирование, особенно на неудачных попытках, важно для моделей разного размера.
Ключевые факты
- Self-Credit, сквозной метод обучения агентов с подкреплением: редкая итоговая награда превращается в плотный сигнал через самосгенерированное распределение заслуг.
- Три компонента: сводки модели со ссылками на ключевые ходы, внутригрупповое масштабирование по удачным и неудачным попыткам, переоценка преимуществ процитированных ходов.
- BrowseComp-Plus: прирост к базовым Qwen3 8B и 32B, 37,0 и 36,2 пункта; отрыв от сильнейших базовых методов агентного обучения с подкреплением, 8,5 и 5,6 пункта.
- Над сильнейшими базовыми методами: +4,9 пункта на GAIA и +4,7 пункта на xBench-DeepSearch.
- Анализ, по заявлению авторов: внутригрупповое масштабирование, особенно на неудачных попытках, важно при разных размерах моделей.
Почему это важно
Распределение заслуг в длинных агентных задачах, известное узкое место: награда приходит только в конце, и непонятно, какие из многих шагов сыграли решающую роль. Self-Credit пытается решить это без отдельной внешней разметки шагов: заслуги назначает сама обучаемая модель через цитирование ключевых ходов, а затем они уточняются сравнением попыток внутри группы. Заявленные приросты на BrowseComp-Plus (37,0 и 36,2 пункта к базовым моделям) велики, но это данные аннотации.
Кому это важно
Исследователям и инженерам, которые обучают поисковых и исследовательских ИИ-агентов с помощью обучения с подкреплением на длинных траекториях, а также тем, кто сравнивает методы агентного обучения с подкреплением на BrowseComp-Plus, GAIA и xBench-DeepSearch. Для широкой аудитории тема нишевая.
Как это применить
Практическая идея из описания метода: заставлять агента в ходе работы формулировать сводки со ссылками на ходы с ключевыми свидетельствами, затем сравнивать, какие ходы цитируются в удачных и неудачных попытках на один и тот же запрос, и по этому сравнению пересчитывать преимущества процитированных ходов. Метод построен поверх группового обучения с подкреплением. О публикации кода, моделей и затратах на обучение в источнике ничего не сказано.
Можно ли доверять
Это работа, представленная на странице Hugging Face Papers; пересказ опирается только на аннотацию. Авторы и организации в источнике не названы. Цифры, приросты в пунктах, а не итоговые показатели: абсолютные баллы на BrowseComp-Plus, GAIA и xBench-DeepSearch не приведены, как и названия и результаты сильнейших базовых методов. Не указано также, какие размеры моделей использовались на GAIA и xBench-DeepSearch. Независимой проверки результатов в источнике нет.
Риски и подводные камни
Сравнения «с сильнейшими базовыми методами» нельзя оценить, не зная, что это за методы. Приросты на GAIA и xBench-DeepSearch не разбиты по Qwen3 8B и 32B. Метод опирается на то, что модель сама правильно цитирует ключевые ходы; авторы показывают, что такие сигналы полезны, а внутригрупповое масштабирование помогает убрать незаслуженные заслуги, но подробности за пределами аннотации в источнике не раскрыты.