Предложен оптимизатор FOAM: вдвое меньше состояния, чем у SOAP
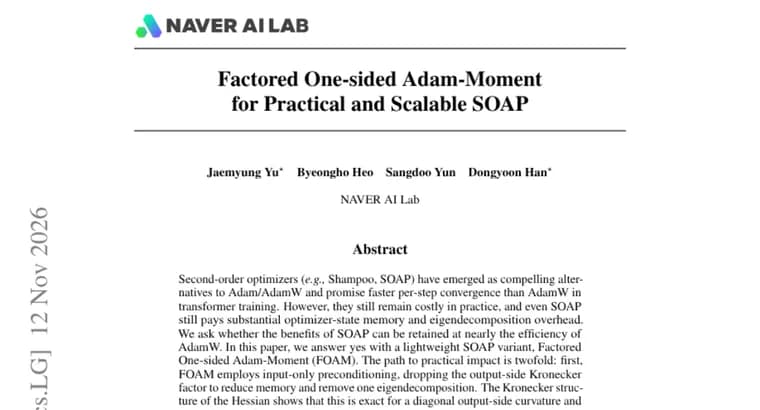
В статье, опубликованной на Hugging Face Papers, предложен оптимизатор FOAM (Factored One-sided Adam-Moment). Это облегчённая версия SOAP, оптимизатора второго порядка, который относится к семейству Shampoo и считается альтернативой Adam/AdamW. Такие методы, по словам авторов, обещают более быструю сходимость на каждом шаге, чем AdamW, при обучении трансформеров. Но на практике они остаются дорогими: даже SOAP требует заметной памяти под состояние оптимизатора и затрат на разложение матриц по собственным значениям. Исходный вопрос авторов: можно ли сохранить преимущества SOAP почти с той же эффективностью, что у AdamW. Их ответ, да, с помощью FOAM.
В FOAM два основных изменения. Первое, предобусловливание только по входной стороне: отбрасывается кронекеров множитель выходной стороны. Это снижает расход памяти и убирает одно из двух разложений по собственным значениям. Авторы ссылаются на кронекерову структуру гессиана: такое упрощение точно для диагональной кривизны на выходной стороне и почти без потерь для близкой к диагональной, что, по их словам, подтверждается эмпирически.
Второе, замена плотного повёрнутого второго момента SOAP на факторизованную оценку момента Adam, построенную на статистиках по строкам и столбцам. При предположении K-FAC о Фишере с диагональной выходной кривизной эта оценка точно воспроизводит плотный второй момент SOAP. Измеренное отклонение от предположения K-FAC составляет лишь 15-20%, и, как утверждают авторы, на обновление параметров оно влияет пренебрежимо мало.
Эмпирические результаты, по утверждению авторов, показывают, что на предобучении больших языковых моделей FOAM по ошибке на валидации не уступает сильным базовым методам SOAP и Muon. При этом он использует вдвое меньше состояния оптимизатора, чем SOAP, работает за время, сопоставимое с Muon (в статье это названо «Muon-class wall-clock time»), и устойчив в трёхкратном диапазоне скорости обучения. Результаты приведены для моделей от 124 млн до 760 млн параметров. Вывод авторов: выигрыш SOAP не обязан требовать затрат SOAP. Код опубликован в репозитории naver-ai/foam на GitHub.
Ключевые факты
- FOAM, облегчённый вариант оптимизатора второго порядка SOAP: отбрасывает кронекеров множитель выходной стороны и убирает одно разложение по собственным значениям.
- Плотный повёрнутый второй момент SOAP заменён факторизованной оценкой момента Adam на статистиках «строки на столбцы»; при диагональной выходной кривизне она точно воспроизводит второй момент SOAP.
- Измеренное отклонение от предположения K-FAC, 15-20%, с пренебрежимо малым влиянием на обновление (по утверждению авторов).
- По заявлению авторов, FOAM не уступает SOAP и Muon по ошибке на валидации, использует вдвое меньше состояния оптимизатора, чем SOAP, и работает со временем уровня Muon.
- Результаты получены при предобучении языковых моделей от 124 млн до 760 млн параметров; код открыт в репозитории naver-ai/foam.
Почему это важно
Оптимизаторы второго порядка вроде Shampoo и SOAP обещают более быструю сходимость на каждом шаге, чем AdamW, но их цена, память и вычислительные затраты на разложение матриц. Авторы FOAM пытаются убрать этот барьер: по их данным, состояние оптимизатора сокращается вдвое относительно SOAP, а время работы остаётся на уровне Muon. Если это подтвердится независимо, выигрыш SOAP станет доступнее на практике.
Кому это важно
Прежде всего тем, кто занимается предобучением языковых моделей и ограничен памятью ускорителей: состояние оптимизатора, заметная часть расхода памяти. Также интересно исследователям оптимизаторов, которые сравнивают SOAP, Muon и AdamW.
Как это применить
Код FOAM опубликован на GitHub в репозитории naver-ai/foam, так что метод можно попробовать на собственной задаче предобучения. Заявленные результаты относятся к масштабу от 124 млн до 760 млн параметров, поэтому разумно сначала сравнить FOAM с вашим текущим оптимизатором на модели такого размера и учесть, что устойчивость заявлена в трёхкратном диапазоне скорости обучения.
Можно ли доверять
Это препринт: в тексте не указаны ни рецензирование, ни площадка публикации. Все утверждения о качестве принадлежат самим авторам. Конкретных чисел ошибки на валидации, перплексии или метрик в аннотации нет, как нет и цифр ускорения или расхода памяти в гигабайтах; про время сказано только «на уровне Muon». Формулировка «не уступает» означает совпадение, а не превосходство над SOAP и Muon. Сильный довод в пользу проверяемости, открытый код.
Риски и подводные камни
Результаты заявлены только для моделей от 124 млн до 760 млн параметров; поведение на больших масштабах авторы не утверждают. Точность упрощения зависит от допущений: одностороннее предобусловливание точно лишь для диагональной выходной кривизны и почти без потерь для близкой к диагональной, а отклонение от предположения K-FAC на практике составило 15-20%. Условия обучения (объём данных, оборудование) в аннотации не описаны, поэтому прямое сравнение с вашей конфигурацией потребует собственных замеров.
«...показывая, что выигрыш SOAP не обязан требовать затрат SOAP.»
— из аннотации статьи о FOAM