PixVid: видеомодель Wan2.1-14B переучили генерировать кадры в пикселях
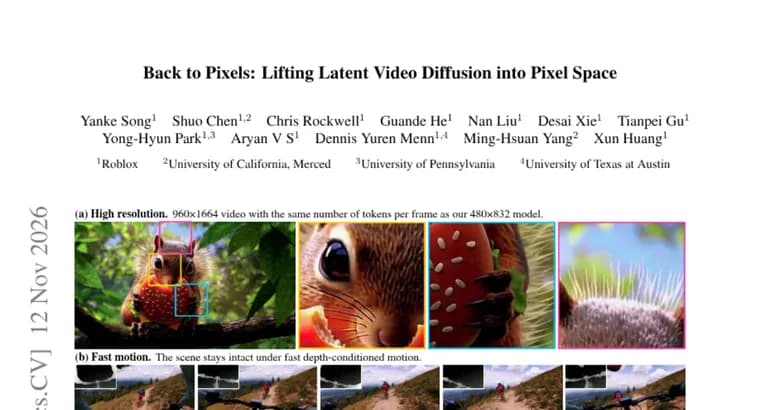
В статье представлен PixVid, метод, который «поднимает» предобученную латентную видеомодель до генерации каждого кадра напрямую в пиксельном пространстве. Исходная точка рассуждений авторов: современные видеомодели работают в латентном пространстве VAE (вариационного автокодировщика), которое сжимает видео и по пространству, и по времени. Такое сжатие сделало обучение посильным, но теперь, по мнению авторов, ограничивает генерацию в высоком разрешении, управляемую и интерактивную генерацию.
Авторы называют три конкретные проблемы латентного подхода. Первая: при удвоении разрешения число токенов вырастает вчетверо. Вторая: условия (например, управляющие сигналы) применяются к группам кадров, а не к отдельным кадрам. Третья: каждый отклик модели приходится ждать до конца своего многокадрового блока.
Устройство PixVid простое: диффузионный трансформер сохраняется, а декодер VAE заменяется сверточной «головой», которая превращает выходы трансформера в пиксели. Авторы отмечают важное наблюдение: ключ к качеству, предсказывать чистое видео, а не скорость (velocity), и использовать больший сдвиг шума (noise shift).
Модель дообучена из Wan2.1-14B. По утверждению авторов, PixVid сопоставим с латентной базовой моделью в пределах примерно 1,3 млн обучающих клипов. Поскольку работа идёт покадрово в пикселях, модель генерирует в два раза более высокое разрешение при том же числе токенов на кадр, сохраняет согласованность видеомонтажа по карте глубины (depth-conditioned editing) при быстром движении и откликается на каждое действие уже в следующем кадре. У проекта есть страница: chenshuo20.github.io/PixVid.
Ключевые факты
- PixVid оставляет диффузионный трансформер предобученной видеомодели и заменяет декодер VAE на сверточную голову, которая выдаёт пиксели.
- Модель дообучена из Wan2.1-14B и, по заявлению авторов, сопоставима с латентной базовой моделью в пределах примерно 1,3 млн обучающих клипов.
- При том же числе токенов на кадр PixVid генерирует в два раза более высокое разрешение; в латентных моделях удвоение разрешения учетверяет число токенов.
- Покадровая работа даёт отклик на действие уже в следующем кадре и удерживает монтаж по карте глубины согласованным при быстром движении.
- По мнению авторов, ключ к качеству, предсказывать чистое видео вместо скорости и использовать больший сдвиг шума.
Почему это важно
Почти все передовые видеомодели сегодня работают в сжатом латентном пространстве. Работа предлагает вернуться к пикселям, не обучая модель с нуля: берётся готовая Wan2.1-14B. Если подход подтвердится, он снимает ограничения, которые авторы относят к латентному сжатию: рост числа токенов при увеличении разрешения, привязку условий к группам кадров и задержку отклика до конца блока.
Кому это важно
Исследователям видеогенерации и разработчикам интерактивных систем, где модель должна реагировать на каждое действие в следующем кадре (управляемые сцены, игровые и симуляционные сценарии). Также тем, кто занимается видеомонтажем с условием по глубине: по заявлению авторов, при быстром движении результат остаётся согласованным.
Как это применить
Это научная статья, а не готовый продукт: источник называет только страницу проекта (chenshuo20.github.io/PixVid) и не сообщает, опубликованы ли код, веса или демо. Практически идею можно изучать как рецепт: сохранить диффузионный трансформер, заменить декодер VAE сверточной головой, предсказывать чистое видео вместо скорости и увеличить сдвиг шума.
Можно ли доверять
Все утверждения исходят от самих авторов и взяты из аннотации. Названия авторов и институтов в тексте нет. Метрики и тесты, по которым PixVid назван «сопоставимым» с латентной базовой моделью, не приведены, поэтому проверить заявление по этому тексту нельзя. Независимой оценки в источнике нет.
Риски и подводные камни
Сопоставимость качества заявлена без конкретных метрик, а оговорка «в пределах примерно 1,3 млн обучающих клипов» не объясняет, как это соотносится с обучением базовой модели. Абсолютные значения разрешения не указаны, только «в два раза выше». Данных о скорости генерации и стоимости вычислений в источнике нет, так что выгода по ресурсам неясна.