Предложен HINT-WAM: самодистилляция для моделей действий робота с подсказкой из будущего видео
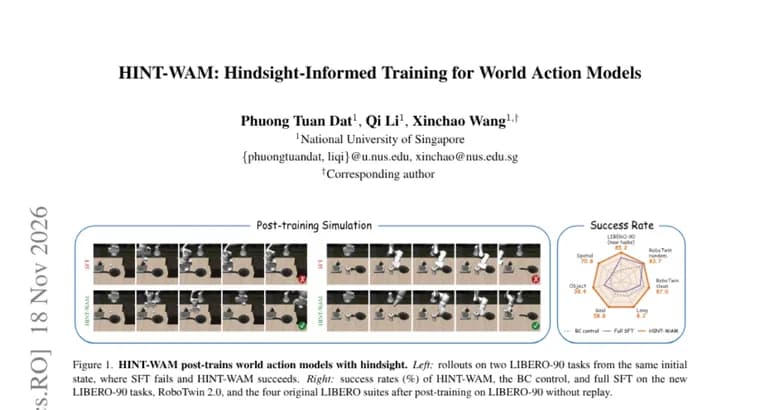
В статье представлен HINT-WAM: метод дообучения «мировых моделей действий» (world action models, WAM) для роботов-манипуляторов. WAM связывают генерацию действий с предсказанием будущей визуальной динамики; по словам авторов, такие модели уже показали многообещающую обобщающую способность и экономность по данным. Но превратить эти свойства в надёжное выполнение задач существующим методам дообучения пока сложно.
Авторы разбирают два привычных подхода. Офлайн-дообучение с учителем (supervised fine-tuning) даёт плотный сигнал на экспертных траекториях, но flow-matching-эксперт по действиям (модуль, который генерирует действия методом согласования потоков) обучается только на зашумлённых действиях из демонстраций и никогда не видит промежуточных состояний, которые порождает его собственный сэмплер. Кроме того, адаптация под конкретную задачу может ухудшить предобученные способности. Обучение с подкреплением на собственном поведении политики упирается в другое: при разреженных наградах трудны исследование среды и распределение заслуг по шагам, а плотная формовка награды всё равно даёт лишь скалярную оценку, а не прямую цель для действия.
HINT-WAM, как утверждают авторы, первая on-policy-самодистилляция (обучение на собственных траекториях модели), где эксперт по действиям получает сигнал на собственных траекториях сэмплирования. Роль привилегированной информации играет «взгляд назад» (hindsight), будущее видео демонстрации, доступное самой WAM.
Устроено это так. Для каждого наблюдения из демонстрации «ученик» генерирует действие через собственную траекторию шумоподавления. В состояниях вдоль этой траектории та же модель выступает «учителем», дополнительно получая «взгляд назад», и выдаёт условное распределение действий, плотную цель для обучения. «Ученик» при этом видит только входы, доступные при развёртывании, а награды среды и взаимодействие с симулятором не нужны.
Чтобы передать этот сигнал flow-matching-эксперту, учителя дистиллируют в ученика с помощью энергетической оценки (energy score). Это цель на уровне распределения: она подгоняет распределение действий ученика, получаемое из его собственных сэмплов, под распределение учителя, а не регрессирует его поле скоростей. Страница проекта: https://tuandattt.github.io/hintwam/.
Ключевые факты
- HINT-WAM, по описанию авторов, первая on-policy-самодистилляция для мировых моделей действий (WAM) в роботизированной манипуляции.
- Эксперт по действиям обучается на собственных траекториях сэмплирования; «учителем» выступает та же модель, дополнительно получающая будущее видео демонстрации как привилегированную информацию.
- Ученик видит только входы времени развёртывания; награды среды и взаимодействие с симулятором не требуются.
- Дистилляция идёт через энергетическую оценку (energy score), сопоставляющую распределения действий, а не через регрессию поля скоростей учителя.
- В аннотации заявлена мотивация и схема метода; количественных результатов она не содержит.
Почему это важно
Авторы указывают на разрыв между потенциалом WAM и надёжным выполнением задач: офлайн-дообучение не видит состояний, которые порождает собственный сэмплер модели, а обучение с подкреплением страдает от разреженных наград. HINT-WAM предлагает третий путь: плотный целевой сигнал на собственных траекториях модели без наград и симулятора. Заявка на первенство («первая on-policy-самодистилляция для WAM») принадлежит самим авторам.
Кому это важно
Прежде всего исследователям робототехники и обучения политик управления, работающим с мировыми моделями действий и flow-matching-экспертами. Идея «модель-учитель с доступом к будущему» может заинтересовать и тех, кто ищет способы дообучения без симулятора и без проектирования наград.
Как это применить
Практических инструкций в аннотации нет. Подробности метода и материалы можно искать на странице проекта: https://tuandattt.github.io/hintwam/. Для воспроизведения понадобится WAM с flow-matching-экспертом по действиям и набор демонстраций с видео.
Можно ли доверять
Это аннотация научной статьи, и все утверждения, слова самих авторов. Количественных результатов в ней нет: ни показателей успешности, ни названий бенчмарков, ни базовых методов для сравнения. Поэтому судить о реальном выигрыше по тексту аннотации нельзя; заявление о «первом» подходе тоже пока не подтверждено независимо.
Риски и подводные камни
Без цифр неизвестно, насколько метод превосходит офлайн-дообучение и обучение с подкреплением. В источнике не названы ни роботы, ни задачи, ни базовые модели, ни затраты на обучение, поэтому переносимость и стоимость метода остаются неясными. Для обучения нужны демонстрации с видео будущего, а значит, подход привязан к данным такого вида.