PostgreSQL 19 вышел: в Databricks Lakebase доступен в день релиза
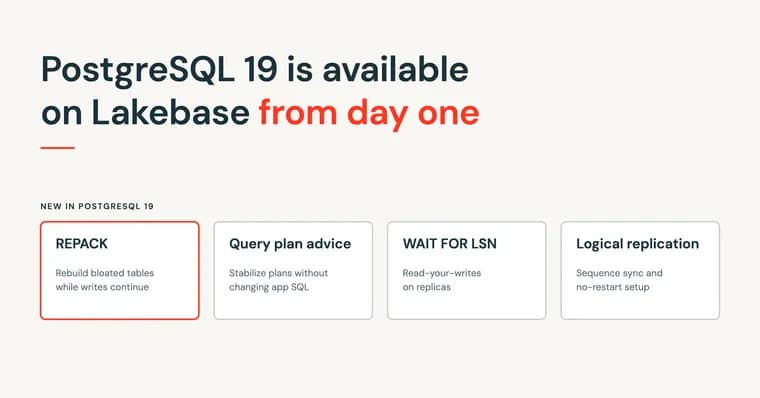
Databricks в своём блоге объявила, что PostgreSQL 19 вышел в общий доступ (GA) и в тот же день стал доступен в Lakebase, её управляемом сервисе Postgres. По словам авторов, новые мажорные версии в других управляемых сервисах PostgreSQL часто появляются спустя недели. Чтобы попробовать, нужно создать новый проект Lakebase и выбрать PostgreSQL 19. Несколько инженеров команды Lakebase, коммиттеры и контрибьюторы PostgreSQL и напрямую работали над этим релизом (подсказки для планировщика, разделяемая память, обработка локалей, управление выпуском).
Главный тезис: релиз практичный, одной главной функции, меняющей суть PostgreSQL, в нём нет. Версия 19 решает давние эксплуатационные проблемы: раздувшиеся таблицы, нестабильные планы запросов, отставание реплик, неполную статистику и сложное в продакшене обслуживание. Общая нить, больше контроля там, где значений по умолчанию недостаточно.
REPACK. Из-за MVCC (многоверсионного управления конкурентным доступом) UPDATE создаёт новую версию строки, а DELETE оставляет «мёртвый» кортеж. Обычный вакуум делает место пригодным для повторного использования, но не возвращает его операционной системе и не восстанавливает физический порядок строк. Привычные средства, VACUUM FULL, CLUSTER или внешний pg_repack, встроенные команды берут блокировку ACCESS EXCLUSIVE на всю операцию. REPACK в версии 19 освобождает место, как VACUUM FULL, а с USING INDEX ещё и упорядочивает строки, как CLUSTER. С CONCURRENTLY таблица перестраивается, пока чтение и запись идут как обычно: изменения перехватываются через логическое декодирование, а в конце берётся ACCESS EXCLUSIVE, чтобы применить оставшиеся изменения и подменить файлы таблицы и индекса. Эта фаза обычно короткая, но на загруженной таблице может занять больше времени.
Ограничения REPACK CONCURRENTLY: нужен дополнительный слот репликации (в пределах max_repack_replication_slots) и таблица с не откладываемым первичным ключом либо подходящим индексом в роли идентификатора реплики; временно требуется место под копию таблицы и всех её индексов, плюс, возможно, файл сортировки размером до таблицы. Текущая upstream-реализация завершается ошибкой, если во время работы в целевой таблице изменено (UPDATE или DELETE) более примерно 104 млн кортежей, считаются изменения за время перепаковки, а не строки, уже лежащие в таблице. Подходят не все типы отношений, долгие транзакции могут задержать финальную блокировку, перепаковка не MVCC-безопасна (транзакции со снимками, сделанными до её начала, после коммита могут увидеть таблицу пустой), а физическая кластеризация со временем деградирует.
Подсказки планировщику. Статистика по отдельным таблицам не ловит межтабличные корреляции. В примере из статьи (гипотетическом) корпоративные клиенты, 0,1% клиентов, но дают 30% заказов; планировщик может выбрать вложенный цикл с многократными обращениями к индексу, хотя уместнее хеш-соединение. Для таких случаев добавлены pg_plan_advice (описывает решения планировщика как подсказки, применяет заданные и сообщает, выполнены ли они) и pg_stash_advice (хранит подсказки по идентификатору запроса и применяет их автоматически). Они не добавляют межтабличную статистику и не заменяют планировщик, а позволяют вмешаться при неточной оценке. В отличие от встроенных в текст запроса хинтов, подсказка живёт вне запроса приложения. Статус matched в EXPLAIN означает лишь, что план соответствует подсказке, а не что он лучше, его нужно проверять на реальной нагрузке. Авторы советуют использовать подсказки как стабилизатор после диагностики: распределения данных меняются, кэшированные подготовленные запросы могут держать старый план.
Обслуживание и диагностика. Автовакуум теперь может использовать параллельные процессы при очистке индексов (параметр autovacuum_max_parallel_workers), а новая система оценок приоритизирует таблицы по срочности очистки или анализа. Новые представления: pg_stat_lock (статистика по типам блокировок), pg_stat_recovery, pg_stat_autovacuum_scores. EXPLAIN (ANALYZE, IO) показывает асинхронный ввод-вывод, auto_explain.log_io включает это в логи; объём WAL от полностраничных образов виден в pg_stat_wal, EXPLAIN (ANALYZE, WAL) и логах вакуума и анализа.
Логическая репликация. Закрыто несколько пробелов: effective_wal_level поднимается до logical при создании первого логического слота, хотя wal_level остаётся replica; поддержана публикация последовательностей (FOR ALL SEQUENCES) и синхронизация их значений перед переключением при обновлениях мажорной версии; CREATE PUBLICATION ... FOR ALL TABLES EXCEPT (...) публикует все таблицы, кроме перечисленных; подписку можно создавать через сервер postgres_fdw (CREATE SUBSCRIPTION ... SERVER); опция retain_dead_tuples позволяет обнаруживать конфликты update_deleted (для этого на подписчике нужен track_commit_timestamp, счётчик конфликтов, в pg_stat_subscription_stats). Начальные значения последовательностей копируются при copy_data = true (по умолчанию), дальнейшие изменения не передаются потоком, поэтому перед переключением их нужно обновить.
WAIT FOR LSN. Асинхронные реплики не заставляют первичный сервер ждать коммитов, но возможно отставание: запись зафиксирована на первичном сервере, а реплика её ещё не видит. WAIT FOR LSN блокирует резервный сервер, пока воспроизведение не дойдёт до нужной позиции WAL. По умолчанию ожидание бессрочное; есть режимы ожидания записи или сброса WAL и таймаут. Номер LSN с первичного сервера на реплику по-прежнему должен передавать клиент или пулер соединений, но опросы и произвольные паузы для read-your-writes больше не нужны.
Прочее. postgres_fdw умеет импортировать статистику с удалённого сервера при ANALYZE (при сбое откатывается к выборке строк, так что удалённая статистика должна быть актуальной), это даёт планировщику точные оценки числа строк и может сменить вложенный цикл на хеш-соединение. INSERT ... ON CONFLICT DO SELECT даёт чистый шаблон «получить или создать» и заменяет обходной DO UPDATE SET col = EXCLUDED.col, который создаёт новую версию строки и мёртвый кортеж при каждом конфликте. COPY TO умеет выдавать JSON (по умолчанию по объекту на строку, FORCE_ARRAY, один массив), но только на экспорт: COPY FROM этот формат не принимает. Есть и мелкие улучшения: функция random(min, max) поддерживает date, timestamp и timestamptz, оконные функции получили IGNORE NULLS и RESPECT NULLS, при io_method = worker число рабочих процессов ввода-вывода масштабируется между io_min_workers и io_max_workers, проверки внешних ключей ускорены.
Наконец, часть крупных функций убрали перед релизом из-за проблем корректности и дизайна, найденных рецензентами: запросы по графам свойств SQL/PGQ (CREATE PROPERTY GRAPH, GRAPH_TABLE; откат 7 сентября 2026 года) и UPDATE и DELETE ... FOR PORTION OF для темпоральных данных (откат 15 сентября 2026 года). Они отложены до следующих версий.
Ключевые факты
- PostgreSQL 19 вышел в общий доступ и в тот же день стал доступен в управляемом сервисе Databricks Lakebase; по словам Databricks, в других управляемых сервисах новые мажорные версии часто появляются спустя недели.
- REPACK (в том числе CONCURRENTLY) перестраивает раздувшиеся таблицы без блокировки на всю операцию; ACCESS EXCLUSIVE берётся только в конце. Есть ограничения: до 104 млн изменённых кортежей, место под копию таблицы и индексов, отсутствие MVCC-безопасности.
- pg_plan_advice и pg_stash_advice позволяют вручную подсказать планировщику план запроса при неточной оценке и сохранить подсказку по идентификатору запроса.
- WAIT FOR LSN закрывает проблему чтения своих записей на асинхронных репликах без опросов и пауз, но LSN по-прежнему должен передавать клиент или пулер соединений.
- Из релиза убрали SQL/PGQ (откат 7 сентября 2026 года) и FOR PORTION OF (откат 15 сентября 2026 года).
Почему это важно
Релиз не приносит одной революционной функции, зато закрывает болевые точки эксплуатации: раздувание таблиц, нестабильные планы, отставание реплик, пробелы логической репликации. REPACK переносит в ядро задачу, которую раньше решали только долгой блокировкой или расширением вроде pg_repack. Для Databricks это ещё и демонстрация скорости: Lakebase выпустила версию в день релиза.
Кому это важно
Администраторам и инженерам баз данных PostgreSQL, командам, которые строят логическую репликацию, миграции между мажорными версиями и конвейеры обработки данных, разработчикам приложений с чтением с реплик и пользователям Lakebase.
Как это применить
В Lakebase достаточно создать новый проект и выбрать версию PostgreSQL 19. Для REPACK CONCURRENTLY заранее проверьте свободные слоты репликации (max_repack_replication_slots), наличие первичного ключа или подходящего идентификатора реплики и запас места на диске. Подсказки планировщику используйте после диагностики проблемного плана: проверьте план через EXPLAIN, протестируйте подсказку, затем сохраните её через pg_stash_advice. Перед переключением при миграции через логическую репликацию обновите значения последовательностей. Цены и ограничения Lakebase в тексте статьи не приведены.
Можно ли доверять
Источник, корпоративный блог Databricks, то есть описание собственного продукта и его преимущества (тезис о том, что другие сервисы обновляются неделями, утверждение самого вендора). Описание самих возможностей PostgreSQL 19 подробное и содержит оговорки и ограничения, а полный список изменений авторы отсылают к официальным заметкам о релизе. Бенчмарков и цифр производительности в тексте нет. Упоминание Neon из заголовка обсуждения на HN в тексте статьи не подтверждается.
Риски и подводные камни
REPACK CONCURRENTLY не MVCC-безопасен: транзакции со старыми снимками могут увидеть таблицу пустой; текущая реализация падает при более чем примерно 104 млн изменённых кортежей во время работы; долгие транзакции могут задержать финальную блокировку, которая на загруженной таблице бывает не короткой. Подсказка со статусом matched не гарантирует улучшения плана. Импорт статистики в postgres_fdw при сбое откатывается к выборке строк, а удалённая статистика должна быть актуальной. Формат JSON в COPY, только на экспорт.
«Нет ни одной главной функции, которая меняла бы суть PostgreSQL.»
— Блог Databricks о PostgreSQL 19 в Lakebase