Отчёт по Kling: качество видео, проекция мультимодального понимания
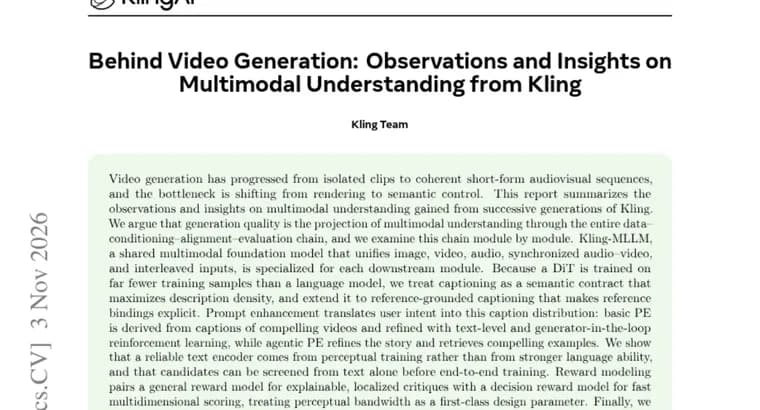
В отчёте, опубликованном на Hugging Face Papers, обобщены наблюдения и выводы о мультимодальном понимании, накопленные за несколько поколений системы генерации видео Kling. Исходная посылка: генерация видео прошла путь от отдельных клипов к связным короткометражным аудиовизуальным последовательностям, а узкое место смещается от отрисовки к семантическому управлению.
Центральный тезис авторов: качество генерации, это проекция мультимодального понимания через всю цепочку «данные, условия, выравнивание, оценка». Эту цепочку они разбирают модуль за модулем. В основе лежит Kling-MLLM, общая мультимодальная базовая модель, которая объединяет изображения, видео, звук, синхронизированные аудио и видео, а также перемежающиеся входы; для каждого последующего модуля её специализируют отдельно.
Подписи к данным (captioning). Поскольку DiT (диффузионный трансформер) обучается на заметно меньшем числе образцов, чем языковая модель, подписи трактуются как «семантический контракт», который максимизирует плотность описания. Подход расширен до подписей с привязкой к референсам, где связи с референсами задаются явно.
Улучшение промптов (prompt enhancement, PE). Оно переводит замысел пользователя в то распределение подписей, на котором учится модель. Базовое PE строится на подписях к удачным видео и дорабатывается с помощью обучения с подкреплением, на уровне текста и с генератором в контуре. Агентное PE дополнительно дорабатывает сюжет и подбирает удачные примеры.
Текстовый кодировщик. Авторы показывают, что надёжный кодировщик получается благодаря перцептивному обучению, а не за счёт более сильных языковых способностей. Кроме того, кандидатов можно отсеивать только по тексту, до сквозного обучения.
Модели вознаграждения. Общая модель вознаграждения даёт объяснимые локализованные критические замечания, а решающая модель, быструю многомерную оценку. «Перцептивная полоса пропускания» рассматривается как полноценный параметр проектирования.
Оценка. Рассмотрены автоматические оценки под конкретные задачи, с упором на протоколы, которые вскрывают лазейки в подсчёте баллов и помогают отследить сбой до его первоисточника. Авторы надеются, что эти уроки станут практическим руководством для построения «стека понимания», на котором держится управляемая генерация видео.
Ключевые факты
- Узкое место генерации видео, по отчёту, смещается от отрисовки к семантическому управлению.
- Авторы утверждают: качество генерации, проекция мультимодального понимания через цепочку «данные, условия, выравнивание, оценка».
- Kling-MLLM, общая мультимодальная модель для изображений, видео, звука, синхронных аудио и видео и перемежающихся входов; её специализируют под каждый модуль.
- Надёжный текстовый кодировщик даёт перцептивное обучение, а не более сильный язык; кандидатов можно отсеивать по одному тексту до сквозного обучения.
- Модели вознаграждения двух видов: общая (объяснимые локальные замечания) и решающая (быстрая многомерная оценка).
Почему это важно
Отчёт фиксирует сдвиг приоритетов в генерации видео: когда клипы стали связными, главным становится не отрисовка, а то, насколько точно система понимает замысел и умеет им управлять. Kling здесь выступает примером системы, на которой авторы разбирают весь путь, от подписей к обучающим данным до оценки результата.
Кому это важно
Прежде всего тем, кто строит или дорабатывает модели генерации видео и конвейеры вокруг них: специалистам по данным и разметке, по обучению с подкреплением и моделям вознаграждения, по оценке качества. Интересно и тем, кто следит за тем, как устроены крупные видеосистемы изнутри.
Как это применить
Отчёт задуман как практическое руководство по «стеку понимания». Из него можно взять конкретные идеи: писать подписи с максимальной плотностью описания и явными привязками к референсам; строить улучшение промптов на подписях к удачным видео; отсеивать текстовые кодировщики по одному тексту до дорогого сквозного обучения; сочетать объяснимую и быструю модели вознаграждения; проверять протоколы оценки на лазейки. Доступность кода и моделей в аннотации не указана.
Можно ли доверять
Это обзорный отчёт самих разработчиков об их опыте, а не независимое исследование. В аннотации нет бенчмарков, метрик, размеров моделей и объёмов обучающих выборок, не названы авторы и организации, поэтому оценить, насколько описанные приёмы улучшают качество видео, по ней нельзя. Утверждения вроде «качество, проекция понимания» стоит читать как позицию авторов.
Риски и подводные камни
Выводы получены на конкретной системе Kling, и неизвестно, как они переносятся на другие архитектуры. Без количественных результатов трудно отделить принципиальные находки от удачных практик. Сведений о том, что Kling-MLLM доступна публично, в аннотации нет, так что повторить описанный подход самостоятельно может быть непросто.
«Мы утверждаем, что качество генерации, это проекция мультимодального понимания через всю цепочку «данные, условия, выравнивание, оценка».»
— Из аннотации отчёта о Kling