Бенчмарк IdeaTaste: нейросети уступают учёным в «научном вкусе»
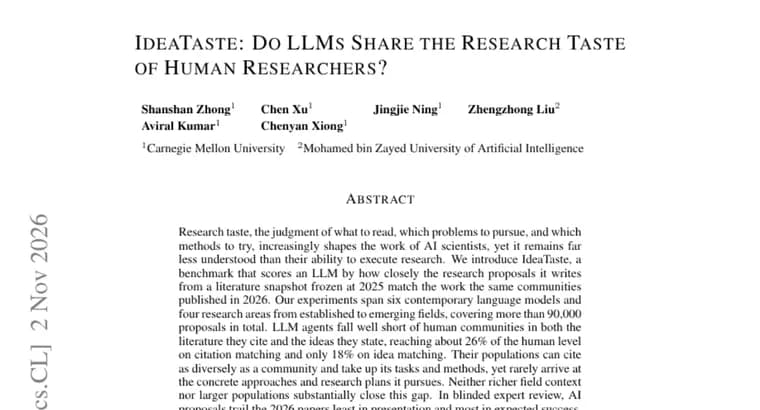
Авторы статьи ввели понятие «научный вкус» (research taste): это умение судить, что читать, какие задачи решать и какие методы пробовать. По их словам, он всё сильнее влияет на работу ИИ-учёных, но изучен заметно хуже, чем способность ИИ выполнять исследования.
Для измерения предложен бенчмарк IdeaTaste. Модели дают срез научной литературы, «замороженный» на 2025 год, и просят написать исследовательские предложения. Затем их сравнивают с тем, что те же научные сообщества реально опубликовали в 2026 году. Эксперименты охватывают шесть современных языковых моделей и четыре области исследований, от устоявшихся до новых, всего более 90 000 предложений.
Главный результат: LLM-агенты заметно уступают человеческим сообществам и в том, какую литературу цитируют, и в том, какие идеи формулируют. По совпадению цитирований они достигают около 26% человеческого уровня, по совпадению идей, только 18%. Эти цифры показывают долю от уровня людей, а не абсолютную точность.
Популяции моделей могут цитировать так же разнообразно, как целое сообщество, и берутся за те же задачи и методы, но редко приходят к конкретным подходам и планам исследований, которые сообщество реально разрабатывает. Более богатый контекст по области и увеличение размера популяции этот разрыв существенно не закрывают.
В слепой экспертной оценке предложения ИИ меньше всего отстают от статей 2026 года по качеству изложения и больше всего, по ожидаемому успеху. Хуже всех оцениваются предложения, чьи идеи не разделяет ни одна человеческая статья; авторы считают, что это указывает скорее на более слабые направления, чем на упущенные другими возможности.
Вывод авторов: главное узкое место научного вкуса у ИИ не в поиске направлений, над которыми работает сообщество, а в превращении их в конкретные подходы, которые оно затем разрабатывает. IdeaTaste выпущен как открытая, постоянно обновляемая таблица результатов (https://cxcscmu.github.io/IdeaTaste), которая сверяет современные предложения ИИ с будущими циклами публикаций.
Ключевые факты
- IdeaTaste оценивает предложения LLM, написанные по литературе, замороженной на 2025 год, по близости к работам тех же сообществ, опубликованным в 2026 году.
- Эксперимент: шесть языковых моделей, четыре области исследований, более 90 000 предложений.
- LLM-агенты достигают около 26% человеческого уровня по совпадению цитирований и 18% по совпадению идей (доли от уровня людей).
- Больше контекста по области и более крупные популяции моделей разрыв существенно не сокращают.
- По выводу авторов, узкое место не в выборе направлений, а в превращении их в конкретные подходы и планы исследований.
Почему это важно
Всё больше говорят об ИИ-учёных, но их способность выполнять эксперименты изучена лучше, чем способность выбирать, что исследовать. IdeaTaste пытается измерить именно выбор: насколько предложения модели совпадают с тем, чем сообщество занялось позже. Результат показывает, что модели неплохо угадывают общее направление, но слабы в конкретных подходах и планах.
Кому это важно
Исследователям, которые строят или используют ИИ для генерации научных идей, авторам бенчмарков и всем, кто оценивает, можно ли доверять машине постановку исследовательских задач. Результат полезен и тем, кто следит за темой «ИИ-учёного».
Как это применить
Авторы выложили IdeaTaste как открытую, постоянно обновляемую таблицу результатов (https://cxcscmu.github.io/IdeaTaste). По ней можно сравнивать современные предложения ИИ с будущими циклами публикаций. Выводы стоит учитывать при проектировании систем идей: по данным работы, больший контекст по области и более крупные популяции моделей разрыв существенно не закрывают.
Можно ли доверять
Это препринт, а материал для пересказа, только его аннотация. Подробности методики не раскрыты: не сказано, как именно считаются совпадения цитирований и идей, какие шесть моделей и четыре области взяты, сколько было экспертов и какие абсолютные значения у человеческого уровня. Цифры 26% и 18%, доли от человеческого уровня, и неизвестно, средние они или максимальные по моделям. Результатов по отдельным моделям нет. Выводы принадлежат самим авторам бенчмарка.
Риски и подводные камни
Сравнение идет с тем, что сообщество опубликовало в 2026 году, а это лишь один из возможных вариантов развития области. Совпадение с ним измеряет близость к реально выбранным направлениям, а не их ценность. Авторы трактуют отсутствие у идей ИИ аналогов в человеческих статьях как признак слабых направлений, но это их интерпретация экспертных оценок. Конкретных чисел оценок экспертов в аннотации нет.
«Эти результаты показывают, что главное узкое место научного вкуса у ИИ заключается не столько в поиске направлений, над которыми работает сообщество, сколько в превращении их в конкретные подходы, которые оно затем разрабатывает.»
— Авторы статьи об IdeaTaste, аннотация