onPanda сократил медианное время разметки данных для ИИ на 52%
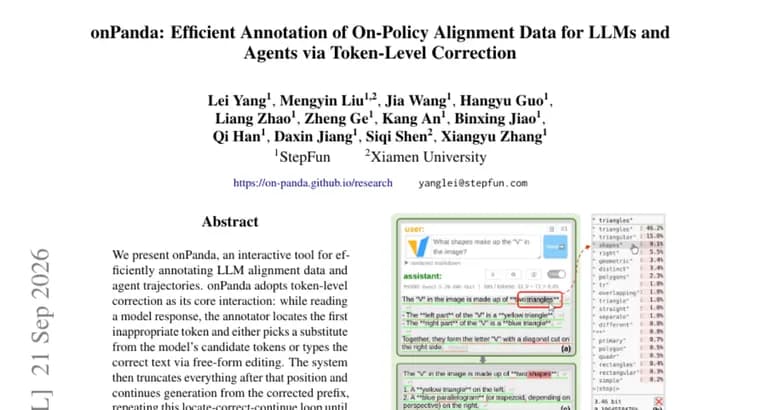
Исследователи представили onPanda, интерактивный инструмент для разметки данных выравнивания (alignment) больших языковых моделей и траекторий ИИ-агентов.
В основе инструмента лежит правка на уровне токена: разметчик читает ответ модели, находит первый неуместный токен и либо выбирает замену из предложенных моделью вариантов, либо вписывает верный текст вручную. После этого система отбрасывает всё, что шло после исправленного места, и продолжает генерацию заново уже от исправленного префикса. Цикл «найти, исправить, продолжить» повторяется, пока итоговый ответ не станет приемлемым.
Такой подход позволяет разметчику точно направлять выход модели при низких затратах: по данным небольшого контролируемого испытания, onPanda сокращает медианное время разметки на 52% по сравнению с ручным пост-редактированием (размер выборки, число участников и условия испытания в источнике не раскрыты).
Поскольку подавляющее большинство токенов в итоговом ответе генерируется самой моделью, получаемые данные в основном сохраняют её исходное распределение сэмплирования, по словам авторов, это делает такой способ разметки хорошо подходящим для построения on-policy данных SFT (supervised fine-tuning, дообучение с учителем) и данных для предпочтений (preference data). Кроме того, зафиксированные в процессе разметки правки на уровне токена дают детальную обратную связь с точными позициями и естественно образуют парные положительные и отрицательные примеры.
onPanda умеет подключаться к внешним инструментам и управляющим средам (harnesses), что позволяет размечать траектории ИИ-агентов интерактивно, в приближенных к реальным условиях.
Вместе с инструментом авторы выпускают датасет Panda-CVL, размеченный с помощью onPanda, и бенчмарк для оценки разметки на уровне токена. Имена авторов и организация-разработчик в самом источнике не указаны.
Ключевые факты
- onPanda, интерактивный инструмент разметки данных выравнивания LLM и траекторий ИИ-агентов через правку на уровне токена
- Разметчик находит первый неверный токен, заменяет его или пишет свой вариант, система обрезает ответ и генерирует его заново от исправленного места (цикл «найти, исправить, продолжить»)
- По данным небольшого контролируемого испытания onPanda сокращает медианное время разметки на 52% по сравнению с ручным пост-редактированием
- Данные сохраняют распределение сэмплирования модели (on-policy) и подходят для SFT и preference-данных; инструмент подключается к внешним средам для разметки агентных траекторий
- Вместе с onPanda выпущены датасет Panda-CVL и бенчмарк для оценки разметки на уровне токена
Почему это важно
Разметка данных выравнивания (alignment) для LLM и агентов, трудоёмкий и дорогой этап: разметчику обычно приходится переписывать ответ модели целиком, даже если ошибка, в одном месте. onPanda предлагает точечную правку на уровне токена вместо полного переписывания, и, по заявленным авторами результатам, вдвое ускоряет эту работу, оставаясь при этом on-policy, то есть не искажая исходное распределение модели, важное для качества последующего дообучения.
Кому это важно
Инструмент адресован командам, которые готовят данные для SFT и предпочтений (preference data) при дообучении и выравнивании языковых моделей и ИИ-агентов: исследовательским лабораториям, командам разметки и разработчикам агентных пайплайнов, которым нужна разметка не только текстовых ответов, но и траекторий действий агента во внешних инструментах.
Как это применить
onPanda встраивается в процесс разметки как интерфейс для правки на уровне токена: разметчик работает с уже сгенерированным ответом модели, а не переписывает его с нуля. Через подключение к внешним инструментам и управляющим средам тот же принцип можно применить к разметке траекторий агента. Кроме самого инструмента, доступны готовый датасет Panda-CVL и бенчмарк, их можно использовать для оценки собственных методов разметки на уровне токена.
Можно ли доверять
Источник, исследовательская публикация на HuggingFace Papers, но в самом тексте не указаны ни авторы, ни организация-разработчик, а ключевая цифра (сокращение времени на 52%) опирается на «небольшое контролируемое испытание», детали которого, число участников, объём выборки, методика, не раскрыты. Это не опровергает результат, но означает, что оценивать его предстоит по мере появления независимой проверки или более подробного описания эксперимента.
Риски и подводные камни
Главный риск, экстраполяция результата небольшого нераскрытого испытания на более широкое применение: 52%-е ускорение получено в контролируемых условиях, которые не описаны, и может не воспроизвестись на других задачах, языках или типах ошибок разметки. Отсутствие имён авторов и институциональной принадлежности в источнике не позволяет оценить, кто стоит за инструментом и насколько независимо оценивались результаты.