BI-Agent поднял точность ИИ в BI-аналитике до 40 п.п.
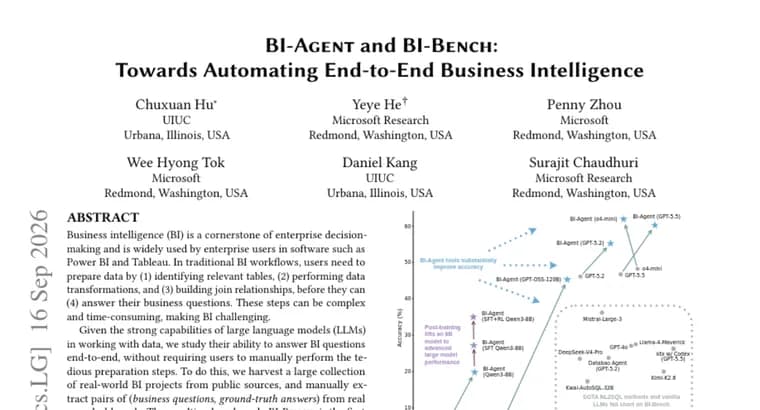
Чусюань Ху с соавторами изучили, способны ли большие языковые модели (LLM) отвечать на вопросы бизнес-аналитики (BI) целиком сами, без того, чтобы человек заранее находил нужные таблицы, готовил трансформации данных и строил связи между таблицами, как это обычно требуется в инструментах вроде Power BI и Tableau.
Для проверки они собрали BI-Bench, набор пар «вопрос, правильный ответ», вручную извлечённых из реальных BI-проектов и дашбордов. Это первый бенчмарк, который систематически проверяет способность LLM решать BI-задачи от начала до конца, от сырых данных до готового ответа. Источник не раскрывает, сколько именно вопросов, проектов или дашбордов вошло в BI-Bench.
Результат: даже передовые LLM без посторонней помощи отвечают правильно менее чем в 50% случаев. Чтобы это исправить, авторы построили BI-Agent, агента с доступом к инструментам, который разбивает рабочий процесс BI на подзадачи над структурированными данными (поиск нужных таблиц, объединение по ключам, трансформация) и координирует специализированные методы работы с данными на каждом этапе, вместо того чтобы просить модель решить всё одним запросом.
Отдельно команда разработала фреймворк постобучения: он синтезирует обучающие траектории из реальных BI-проектов, на которых BI-Agent затем дообучают методами SFT (supervised fine-tuning) и RL (reinforcement learning, обучение с подкреплением). По заявлению авторов, сам BI-Agent даёт обычным (vanilla) LLM прирост точности до 40 процентных пунктов, а дообученная версия агента добавляет к этому ещё до 30 пунктов, источник не уточняет, относительно какой базовой точности считается этот дополнительный прирост. Авторы заключают, что для сложных BI-сценариев важно сочетать рассуждения с внешними инструментами и дообучение под конкретный домен, а не полагаться на общие способности модели.
Ключевые факты
- BI-Bench, новый бенчмарк из пар «вопрос-ответ», вручную извлечённых из реальных BI-проектов и дашбордов; это первый бенчмарк для сквозной проверки LLM на BI-задачах, от сырых данных до готового ответа
- Передовые LLM без вспомогательных инструментов отвечают на BI-вопросы правильно менее чем в 50% случаев
- BI-Agent разбивает рабочий процесс BI на подзадачи (поиск таблиц, объединение, трансформация данных) и координирует специализированные методы на каждом этапе
- BI-Agent поднимает точность обычных LLM до 40 процентных пунктов; после дообучения (SFT и RL) на траекториях из реальных BI-проектов агент добавляет ещё до 30 пунктов
- Источник не называет ни авторов и организации в основном тексте, ни размер BI-Bench, ни базовую точность для расчёта дополнительных 30 пунктов
Почему это важно
Бизнес-аналитика, рутинная, но трудоёмкая часть работы с данными: прежде чем ответить на вопрос вроде «какая выручка по регионам за квартал», человеку нужно найти нужные таблицы, свести их и преобразовать данные. Работа показывает, что сами по себе современные LLM с этим справляются плохо, правильный ответ реже чем в половине случаев. Это важный сигнал: способность модели поддержать беседу не означает способность довести до конца многошаговую задачу над реальными структурированными данными. BI-Agent демонстрирует, что разбиение задачи на управляемые подзадачи и последующее дообучение на реальных траекториях закрывают значительную часть этого разрыва.
Кому это важно
Прежде всего, командам, которые строят ИИ-агентов и копайлотов для аналитики и данных, а также разработчикам инструментов уровня Power BI и Tableau, ищущим способ автоматизировать подготовку данных. Полезно и исследователям, оценивающим агентные возможности LLM на структурированных данных: BI-Bench даёт для этого воспроизводимую метрику. Бизнес-пользователям BI-систем работа интересна как индикатор того, что автоматизация подготовки данных силами ИИ пока далека от надёжной «из коробки».
Как это применить
Ключевая идея BI-Agent переносима: вместо того чтобы поручать LLM всю BI-задачу одним запросом, её раскладывают на типовые подзадачи над структурированными данными, поиск релевантных таблиц, объединение по связям, трансформацию, и на каждом этапе используют специализированный метод, а не общий языковой вывод. Второй переносимый элемент, постобучение на траекториях, синтезированных из реальных проектов: команда, располагающая архивом реальных BI-кейсов, может дообучить похожего агента методами SFT и RL. Источник не сообщает, выложены ли код BI-Agent, датасет BI-Bench или веса моделей в открытый доступ, об этом можно только уточнять на странице публикации.
Можно ли доверять
Материал, исследовательская публикация на HuggingFace Papers, с пересказанным авторами текстом аннотации и описанием метода; сама страница не сообщает имён авторов, организаций и места публикации, а размер бенчмарка (число вопросов, проектов, дашбордов) в тексте не указан. Приведённые цифры, это оценки, представленные самими авторами работы, независимой проверки в источнике нет. Указание «up to» («до») в обоих числах приростов говорит о том, что это, по всей видимости, максимальные, а не средние показатели.
Риски и подводные камни
Меньше 50% точности даже у передовых моделей, это низкая база, и её нужно держать в уме при чтении заголовков про «прирост в 40 пунктов»: итоговая точность агента всё равно может оставаться далёкой от надёжного уровня для реального бизнес-использования. Прирост «до 30 пунктов» от дообучения приведён без указания базы сравнения, так что судить о реальном эффекте постобучения по одной этой цифре нельзя. Источник ничего не говорит о стоимости, задержке или инфраструктурных требованиях запуска BI-Agent, а также о доступности кода и данных, эти вопросы остаются открытыми для тех, кто захочет воспроизвести результат.