OmniVBench: бенчмарк и датасет для генерации видео по референсам
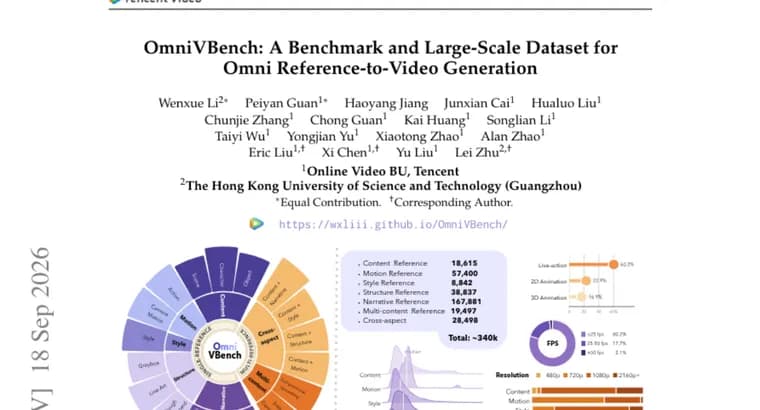
Генерация видео по референсам (reference-to-video, R2V) движется к всё более универсальному и гибкому управлению референсами: модель должна учитывать сразу несколько типов образцов, по содержанию, движению, стилю, структуре, сюжету, и правильно их сочетать. Авторы работы отмечают, что существующие бенчмарки для этой задачи отстают: их тестовые наборы охватывают ограниченный набор типов референсов и их сочетаний, а протоколы оценки в основном проверяют общее сходство с референсом целиком, но не смотрят, сохранён ли, правильно ли разделён и верно ли применён к цели каждый отдельный референсный фактор. Отдельная проблема, обучающие данные: их создание для такой универсальной генерации (omni R2V) дорого, поэтому подходящих датасетов мало.
Чтобы закрыть оба пробела, исследователи выпустили два инструмента. Первый, бенчмарк OmniVBench: он охватывает 7 семейств задач и 18 узких подзадач, распределённых по содержанию, движению, стилю, структуре, сюжету и сценариям с несколькими референсами одновременно. Его ключевая особенность, «факторно-обоснованная» оценка (factor-grounded evaluation) на основе 12 172 чек-листов, составленных под конкретные тестовые случаи: каждый проверяет, сохранён ли нужный референсный фактор, правильно ли он отделён от остальных и привязан к своей цели, и реализован ли он именно так, как требует инструкция, а не просто «похоже ли видео на референс в целом».
Второй инструмент, датасет Omni-R2V Dataset для обучения моделей: 340 тысяч обработанных обучающих примеров, охватывающих разные типы референсов и их сочетания. Материалом послужил большой корпус профессиональных видеозаписей, а для построения пар «референс, цель» под каждую конкретную задачу авторы разработали отдельные конвейеры обработки, по их словам, это даёт практичный и масштабируемый способ собирать данные для универсальной R2V-генерации.
На OmniVBench авторы протестировали ряд современных открытых и закрытых моделей R2V-генерации. Тестирование показало отчётливые разрывы в качестве между разными семействами задач и измерениями оценки, то есть у нынешних моделей остаются заметные слабые места именно в работе с отдельными референсными факторами. Какие именно модели тестировались и какие числовые показатели они получили, в источнике не указано.
Ключевые факты
- Бенчмарк OmniVBench охватывает 7 семейств задач и 18 узких подзадач, по содержанию, движению, стилю, структуре, сюжету и мультиреференсным сценариям.
- Оценка «факторно-обоснованная»: 12 172 чек-листа под конкретные случаи проверяют, сохранён ли, отделён ли и правильно ли привязан к цели каждый референсный фактор, а не только общее сходство.
- Датасет Omni-R2V Dataset даёт 340 тысяч обучающих примеров, собранных из корпуса профессиональных видеозаписей отдельными конвейерами под каждую задачу.
- Тесты существующих открытых и закрытых R2V-моделей на OmniVBench выявили заметные разрывы в качестве между семействами задач, конкретные модели и цифры авторы не назвали.
- Работа закрывает сразу два пробела: неполноту прежних бенчмарков и дефицит обучающих данных для универсальной генерации видео по референсам (omni R2V).
Почему это важно
Генерация видео по референсам движется к универсальному режиму (omni R2V), где модель разом работает с разными типами образцов, по содержанию, движению, стилю, структуре, сюжету. Но прежние бенчмарки проверяли лишь ограниченный набор таких типов и их сочетаний и смотрели только на общее сходство с референсом, упуская, сохранён ли и правильно ли применён каждый отдельный фактор. Вдобавок обучающие данные для этой задачи дороги в производстве и потому дефицитны. OmniVBench и Omni-R2V Dataset закрывают оба пробела одновременно, и оценку, и обучение.
Кому это важно
Исследователям и инженерам, которые разрабатывают модели генерации видео по референсам, как открытые, так и закрытые системы, особенно если модель должна сочетать несколько референсов разных типов одновременно.
Как это применить
Бенчмарк OmniVBench (7 семейств задач, 18 подзадач, 12 172 чек-листа) позволяет проверять модель не по общему сходству с референсом, а по каждому конкретному фактору, сохранён ли он, правильно ли отделён от других и верно ли привязан к цели согласно инструкции. Датасет Omni-R2V Dataset (340 тысяч примеров с готовыми парами «референс, цель») можно использовать для обучения и дообучения моделей на разнообразных типах референсов и их сочетаниях.
Можно ли доверять
Материал, препринт на странице Hugging Face Papers; в аннотации не указаны ни площадка публикации, ни дата выхода, ни полный список авторов и организаций. Методология описана подробно и детально (число задач, чек-листов, объём датасета), что говорит в пользу добросовестной работы, но независимая проверка результатов по первоисточнику здесь не проводилась.
Риски и подводные камни
Авторы заявляют «отчётливые разрывы» в качестве моделей на OmniVBench, но не называют ни конкретные протестированные модели, ни числовые показатели, проверить масштаб разрыва невозможно. Также не раскрыты происхождение и лицензирование корпуса профессиональных видеозаписей, легшего в основу датасета, это стоит уточнить, прежде чем использовать Omni-R2V Dataset в собственных проектах.