MintAct: единая модель ИИ-агента для интерфейсов достигла рекорда на OSWorld-Verified
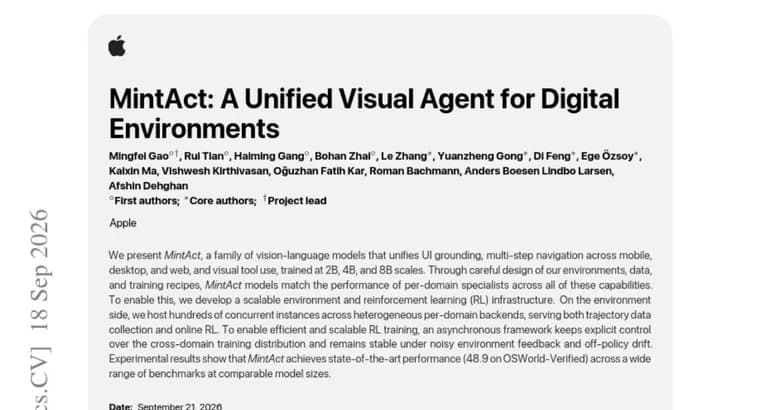
Исследователи представили MintAct, семейство моделей, объединяющих зрение и язык (vision-language models), для управления компьютерными и мобильными интерфейсами. Модель заточена сразу под три способности, которые раньше решались разными узкоспециализированными моделями по отдельности: распознавание расположения и назначения элементов на экране (UI grounding), многошаговую навигацию по мобильным, десктопным и веб-средам и использование визуальных инструментов. Авторы обучили три версии MintAct, на 2, 4 и 8 миллиардов параметров, и утверждают, что по каждому из трёх направлений единая модель не уступает специализированным моделям, обученным только под одну задачу; какие именно специализированные модели брались для сравнения, в тексте не названо.
Чтобы обучить такую модель, команда построила отдельную инфраструктуру: масштабируемую среду и систему обучения с подкреплением (RL, reinforcement learning), которая одновременно держит сотни запущенных инстансов сред на разных платформах-бэкендах, и для сбора данных о траекториях действий агента, и для онлайн-RL. Само обучение ведёт асинхронный фреймворк, который явно управляет распределением обучающих данных между доменами (мобильный/десктоп/веб) и остаётся стабильным даже при шумной обратной связи от среды и при отставании обучаемой политики от актуальных данных (off-policy дрейфе).
По заявлению авторов, на бенчмарке OSWorld-Verified MintAct набрала 48.9 балла, это преподносится как state-of-the-art (лучший результат на сегодня) среди моделей сопоставимого размера. Авторы также говорят о state-of-the-art результатах на широком наборе бенчмарков в целом, но, кроме цифры по OSWorld-Verified, других конкретных результатов в тексте не приводится. Ничего не сказано и о дате релиза, лицензии или доступности кода и весов модели.
Ключевые факты
- MintAct, семейство vision-language моделей на 2, 4 и 8 млрд параметров, которое одной моделью объединяет распознавание элементов интерфейса, многошаговую навигацию по мобильным, десктопным и веб-средам и использование визуальных инструментов.
- По качеству единая модель, по утверждению авторов, не уступает специализированным моделям, обученным под каждую из этих задач по отдельности.
- На бенчмарке OSWorld-Verified MintAct показала 48.9 балла, заявлено как state-of-the-art среди моделей сопоставимого размера.
- Для обучения построена RL-инфраструктура, которая одновременно держит сотни параллельных инстансов сред на разных платформах для сбора траекторий и онлайн-обучения с подкреплением.
- Асинхронный фреймворк обучения управляет распределением данных между доменами и остаётся стабильным при шумной обратной связи среды и off-policy дрейфе.
Почему это важно
До сих пор задачи агента на интерфейсах, понять, куда нажать, пройти многошаговый сценарий на телефоне, компьютере или в браузере, воспользоваться визуальным инструментом, решались отдельными специализированными моделями под каждую из них. MintAct показывает, что одна модель на 2, 8 млрд параметров способна закрыть все эти задачи сразу, не теряя в качестве относительно специализированных решений, по крайней мере по утверждению самих авторов. Это шаг к более простым и дешёвым в эксплуатации ИИ-агентам для интерфейсов, которым не нужно переключаться между разными моделями под разные среды.
Кому это важно
Прежде всего, командам, которые разрабатывают ИИ-агентов для автоматизации работы с интерфейсами: мобильными приложениями, десктопными программами и веб-сайтами. Также это интересно исследователям RL-инфраструктуры для агентов: описанная система с сотнями параллельных инстансов сред и асинхронным обучением, отдельный инженерный результат, применимый шире одной конкретной модели.
Как это применить
В тексте источника нет ни даты релиза, ни условий лицензии, ни сведений о доступности кода или весов моделей, на данный момент это исследовательская публикация о результатах, а не готовый к использованию продукт или открытый релиз.
Можно ли доверять
Заявления о качестве и о state-of-the-art результате основаны на собственных экспериментах авторов и пока не независимо перепроверены. Единственная числовая метрика в источнике, 48.9 балла на OSWorld-Verified; про "широкий набор бенчмарков", на которых тоже заявлен state-of-the-art, конкретных цифр не приведено. Не названы ни специализированные модели, с которыми сравнивали MintAct, ни объём обучающих данных, ни вычислительный бюджет, это ограничивает возможность проверить заявления со стороны.
Риски и подводные камни
Главный риск, судить о результате по одному-единственному приведённому числу: 48.9 на OSWorld-Verified, это state-of-the-art лишь на одном из тестов, а более широкое заявление о лидерстве на других бенчмарках ничем не подкреплено в самом источнике. Плюс к этому, обычные для нового исследования неизвестные: устойчивость RL-инфраструктуры и асинхронного обучения на других задачах, воспроизводимость результатов сторонними командами и то, будут ли модель и код вообще открыты.