NSD: метод самодистилляции учит LLM избегать ошибочных рассуждений
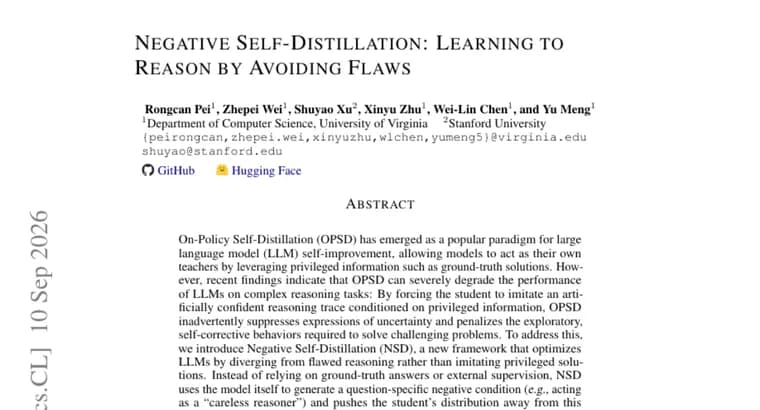
On-policy самодистилляция (OPSD), популярный способ самостоятельного улучшения больших языковых моделей (LLM): модель выступает сама себе учителем, опираясь на привилегированную информацию, например эталонные (заведомо правильные) решения. Однако, по недавним наблюдениям, на которые ссылаются авторы новой работы, OPSD способен серьёзно портить качество модели именно на сложных задачах, требующих рассуждения. Причина, как объясняют авторы, в том, что модель-«ученика» заставляют подражать искусственно уверенному ходу рассуждений, построенному с оглядкой на уже известный правильный ответ. Из-за этого подавляются естественные проявления неуверенности и то самое исследовательское, самокорректирующееся поведение, умение остановиться, усомниться, попробовать другой путь, без которого сложные задачи не решить.
Чтобы обойти эту проблему, авторы предлагают Negative Self-Distillation (NSD), фреймворк, который обучает модель не подражанию привилегированному решению, а расхождению с заведомо ошибочным рассуждением. Никаких эталонных ответов или внешнего контроля NSD не требует: модель сама, для конкретного вопроса, генерирует «отрицательный» пример, рассуждение, которое получится, если попросить её выступить в роли «небрежного мыслителя», то есть нарочно рассуждать неаккуратно. Дальше обучение подталкивает распределение ответов модели-«ученика» подальше от этого самостоятельно сгенерированного «отрицательного учителя».
Наивно применить здесь методы «отучивания» (unlearning), то есть просто наказывать модель за токены неудачного рассуждения, не получится: токены, отвечающие за ошибочную логику, перемешаны с обычными, базовыми языковыми токенами, и наказание без разбора рискует катастрофически испортить сами языковые способности модели. Авторы решают это динамическим механизмом отбора токенов (gating): он автоматически находит и обособляет именно те токены, которые критичны для хода рассуждения, и обновления весов модели бьют только по ним, не трогая базовые языковые способности.
По утверждению авторов, на практике NSD стабильно превосходит и OPSD, и другие методы обучения с подкреплением, которые не используют разметку и опираются на собственные генерации модели (self-bootstrapping). Сам текст работы не называет конкретных цифр прироста, тестовых наборов или размеров моделей, на которых проводилось сравнение, как и имена авторов, их место работы или дату публикации: это только аннотация препринта.
Ключевые факты
- По недавним наблюдениям, на которые ссылаются авторы, on-policy самодистилляция (OPSD), популярный способ учить LLM рассуждению на собственных, подсказанных эталоном решениях, может серьёзно портить качество модели на сложных задачах: заставляя её имитировать искусственно уверенный ход мысли, OPSD подавляет неуверенность и то самое исследовательское, самокорректирующееся поведение, которое нужно для решения трудных задач.
- Авторы предлагают Negative Self-Distillation (NSD), фреймворк, который вместо подражания эталонному решению обучает модель расходиться с заведомо ошибочным, «небрежным» рассуждением, которое модель генерирует сама; никаких эталонных ответов или внешнего контроля NSD не требует.
- Наивное применение методов «отучивания» (unlearning) рискует испортить и базовые языковые способности модели, потому что токены ошибочной логики перемешаны с обычными языковыми токенами; авторы решают это динамическим механизмом отбора токенов, который наказывает только те токены, что отвечают за ошибочное рассуждение.
- По утверждению авторов, на практике NSD стабильно превосходит и OPSD, и другие безразметочные методы обучения с подкреплением, использующие собственные генерации модели (self-bootstrapping); конкретных цифр прироста или названий тестовых наборов в тексте нет.
- Источник, аннотация arXiv-препринта: в тексте нет ни имён и места работы авторов, ни даты публикации, ни размеров или семейств моделей, на которых получен результат.
Почему это важно
Самостоятельное улучшение моделей без дорогой внешней разметки, одно из главных направлений в обучении LLM рассуждению, и OPSD успел стать одним из популярных для этого инструментов. Проблема в том, что, по недавним наблюдениям, на которые ссылаются авторы новой работы, у OPSD есть системный изъян: он учит модель имитировать уверенный ход мысли, подсказанный заранее известным правильным ответом, а значит отучает её от естественной неуверенности и того самого исследовательского, самокорректирующегося поведения, которое и нужно для решения по-настоящему сложных задач. NSD учит модель тому же самому, избегать плохих рассуждений, но без этого побочного эффекта и вовсе без эталонных ответов, что расширяет круг задач, где самообучение вообще применимо.
Кому это важно
Тем, кто обучает или дообучает языковые модели рассуждению, по математике, коду, логическим задачам, методами самодистилляции или безразметочного обучения с подкреплением. Особенно тем, кто уже использует OPSD или рассматривает его: описанный в статье изъян бьёт именно по сложным задачам, где эффект от такого обучения наиболее ожидаем. Пригодится и тем, кто в принципе проектирует цели «отучивания» (unlearning) для языковых моделей, предложенный механизм отбора токенов решает проблему, которая шире одной конкретной задачи.
Как это применить
Вместо рецепта OPSD (дать модели эталонный ответ → получить по нему уверенный ход рассуждений → дистиллировать модель в его сторону) NSD предлагает другой порядок действий: попросить модель сгенерировать заведомо небрежное, ошибочное рассуждение по тому же вопросу, без каких-либо эталонных ответов, а затем обучать модель отдаляться от этого собственного примера. Ключевая деталь реализации, не наказывать все токены «плохого» рассуждения одинаково: сначала динамический механизм отбора должен выделить именно те токены, что отвечают за ошибочную логику, и только по ним пускать сигнал расхождения, оставляя базовые языковые способности модели нетронутыми. Это исследовательский фреймворк, описанный в препринте, не готовый продукт: ни кода, ни лицензии, ни условий доступа аннотация не упоминает.
Можно ли доверять
Источник, аннотация одной конкретной научной работы, судя по номеру, arXiv-препринт: результаты не проходили независимую проверку или рецензирование на момент публикации аннотации. Утверждение, что OPSD способен портить качество рассуждения, в тексте приписано «недавним наблюдениям» без указания, чьим именно и в какой работе они получены. Заявление, что NSD «стабильно превосходит» OPSD и другие методы, это собственный эмпирический результат авторов, поданный без единой цифры: ни величины прироста, ни названия тестовых наборов, ни размеров или семейств моделей, на которых получен результат, аннотация не называет. Имена, место работы авторов и точная дата публикации в тексте тоже отсутствуют. Судить о реальном масштабе преимущества по одной этой аннотации нельзя, только о том, что оно заявлено.
Риски и подводные камни
Главный риск называют сами авторы: наивно наказывать модель за все токены «плохого» рассуждения нельзя, токены ошибочной логики перемешаны с обычными языковыми токенами, и наказание без разбора грозит катастрофически испортить сами языковые способности модели. Именно поэтому в методе появляется отдельный, динамический механизм отбора токенов, и от того, насколько точно он отделяет «плохую» логику от обычного языка на практике, зависит, сработает ли метод вообще, а не только в теории. Это исследовательский фреймворк на стадии препринта, а не готовый инструмент или продукт: ни кода, ни весов моделей, ни условий доступа аннотация не упоминает.