Nemotron 3 Ultra набрала 30 из 42 баллов на IMO 2026, уровень золотой медали
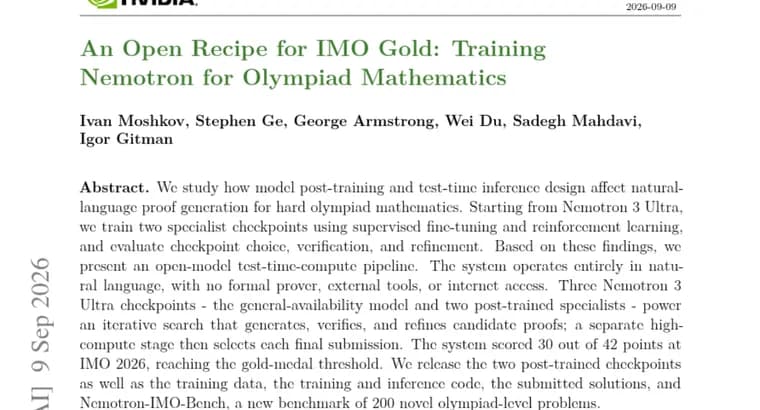
Исследователи изучили, как выбор способа дообучения и устройство вычислений на этапе применения модели (test-time compute) влияют на способность языковой модели генерировать доказательства сложных олимпиадных математических задач на естественном языке. За основу взяли модель Nemotron 3 Ultra и дообучили из неё два специализированных чекпоинта, с помощью SFT (дообучения с учителем) и RL (обучения с подкреплением). Затем оценили, как на качество итоговых доказательств влияют выбор чекпоинта, способ проверки решения и его доработка. Опираясь на эти наблюдения, команда собрала итоговый конвейер вычислений на этапе применения модели, построенный целиком на открытых моделях.
Система работает полностью на естественном языке: в ней нет ни формального доказчика, программы для строгой проверки математических выкладок, ни внешних инструментов, ни доступа в интернет. В конвейере одновременно участвуют три чекпоинта Nemotron 3 Ultra: исходная общедоступная версия модели и два дообученных специалиста. Они проводят итеративный поиск, генерируют варианты доказательства, проверяют их и дорабатывают, а затем отдельный ресурсоёмкий этап отбирает, какой из вариантов отправить как финальный ответ на каждую задачу.
По итогам система набрала 30 баллов из 42 возможных на Международной математической олимпиаде (IMO) 2026 года, этот результат достигает уровня, который засчитывается как золотая медаль.
Вместе с результатом команда выложила в открытый доступ оба дообученных чекпоинта, данные, на которых их обучали, код для обучения и для инференса модели, решения, поданные на IMO 2026, и новый бенчмарк Nemotron-IMO-Bench, набор из 200 новых задач олимпиадного уровня.
Ключевые факты
- Система на основе Nemotron 3 Ultra набрала 30 из 42 баллов на IMO 2026, результат уровня золотой медали.
- Из базовой модели Nemotron 3 Ultra дообучили два специализированных чекпоинта, методами SFT (дообучение с учителем) и RL (обучение с подкреплением).
- Итоговый конвейер объединяет три чекпоинта Nemotron 3 Ultra (базовую версию и двух специалистов) в цикле «сгенерировать → проверить → доработать», а отдельный ресурсоёмкий этап отбирает финальный ответ.
- Система работает целиком на естественном языке, без формального доказчика, внешних инструментов и доступа в интернет.
- В открытый доступ выложены оба дообученных чекпоинта, обучающие данные, код обучения и инференса, поданные решения и новый бенчмарк Nemotron-IMO-Bench из 200 задач олимпиадного уровня.
Почему это важно
Результат уровня золотой медали IMO получен без закрытых компонентов: без специального формального доказчика, без внешних инструментов и без доступа в интернет, только на естественном языке и открытых весах модели. Важна и вторая часть: команда не просто заявила о результате, а раскрыла весь путь к нему, выложила дообученные чекпоинты, обучающие данные, код обучения и инференса и сами поданные решения, то есть сделала результат воспроизводимым, а не только продемонстрированным.
Кому это важно
В первую очередь, исследователям, которые занимаются рассуждением языковых моделей: постдообучением (SFT и RL) и вычислениями на этапе применения модели (test-time compute) для сложных многошаговых математических задач. Также, командам, которые строят или сравнивают системы генерации доказательств без формальных доказчиков и внешних инструментов, и тем, кому нужен новый набор олимпиадных задач для проверки моделей: для этого выпущен Nemotron-IMO-Bench из 200 задач. И тем, кто хочет воспроизвести или доработать результат самостоятельно, чекпоинты, данные и код открыты.
Как это применить
Всё нужное для повторения или доработки результата выложено в открытый доступ: два дообученных чекпоинта Nemotron 3 Ultra, данные, на которых их обучали, код для обучения и для инференса модели, решения, поданные на IMO 2026, и новый бенчмарк Nemotron-IMO-Bench, 200 задач олимпиадного уровня. Это позволяет запустить готовый конвейер как есть, три чекпоинта, итеративный поиск «сгенерировать → проверить → доработать» и отдельный ресурсоёмкий этап отбора финального ответа, переобучить специализированные чекпоинты на своих данных или проверить собственную модель на Nemotron-IMO-Bench.
Можно ли доверять
Результат заявляет и оценивает та же команда, что дообучала модель и строила конвейер, независимого подтверждения в тексте нет. Не приведено ни точное число, начиная с которого результат засчитывается как золотая медаль IMO, ни сравнение с результатами других ИИ-систем или живых участников олимпиады: числу 30 из 42 стоит доверять как отчёту авторов о собственном результате, а не как независимо проверенному факту. При этом дообученные чекпоинты, обучающие данные, код и сами поданные решения выложены в открытый доступ, так что путь от исходной модели до итогового ответа можно при желании проверить и повторить самостоятельно, а не просто поверить на слово.
Риски и подводные камни
Отдельный ресурсоёмкий этап, который отбирает финальный ответ, описан только тем, что он отбирает, сам механизм отбора не раскрыт, и неясно, насколько дорого воспроизвести результат на своих вычислительных мощностях. Не опубликовано и то, какой именно эффект по отдельности дали выбор чекпоинта, проверка и доработка решений: авторы говорят, что оценили это, но конкретных цифр по каждому компоненту нет, и со стороны оценить вклад каждой части конвейера нельзя. Наконец, результат получен и раскрыт только на задачах уровня IMO, как система поведёт себя на других математических или логических задачах, из текста не следует.