Новый метод обучает ИИ-агента с подкреплением и передачей опыта
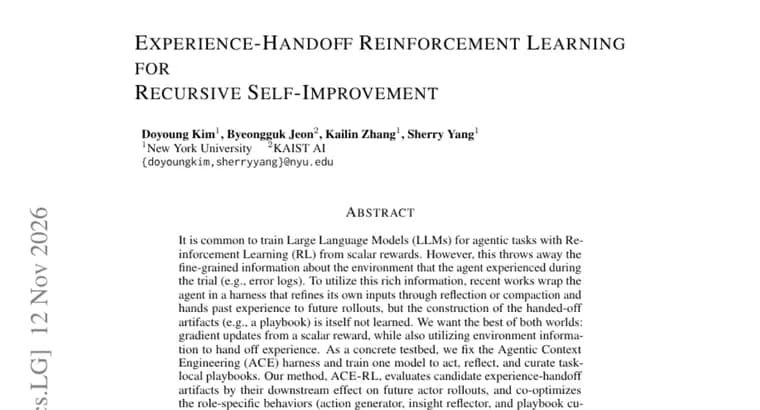
В аннотации статьи на Hugging Face Papers описана проблема обучения больших языковых моделей для агентных задач. Обычно такие модели обучают обучением с подкреплением (RL) по скалярной награде, то есть по одному числу. Авторы отмечают, что при этом теряется детальная информация о среде, которую агент увидел во время попытки, например журналы ошибок.
Чтобы использовать эту информацию, в недавних работах агента помещают в «обвязку» (harness). Она улучшает входные данные агента через рефлексию или сжатие и передаёт прошлый опыт будущим прогонам. Но сами передаваемые артефакты, например плейбук (свод заметок и правил для задачи), в таких подходах не обучаются.
Авторы хотят совместить оба подхода: градиентные обновления по скалярной награде и использование информации о среде для передачи опыта. В качестве испытательного стенда они фиксируют обвязку Agentic Context Engineering (ACE) и обучают одну модель трём ролям: действовать, рефлексировать и составлять плейбуки под конкретную задачу.
Метод оценивает кандидатов на роль передаваемого опыта по их влиянию на последующие прогоны исполнителя. При фиксированном каркасе он совместно оптимизирует поведение в трёх ролях: генератор действий, «рефлектор» выводов и составитель плейбука. По заявлению авторов, на агентных бенчмарках метод даёт более высокое качество на отложенных (не использовавшихся при обучении) данных, чем базовые методы.
Вывод авторов: обучение агентов должно оптимизировать не только действия в текущем прогоне, но и написанный самой моделью опыт, который наследуют будущие прогоны. В тексте аннотации название метода пропущено, цифр, названий бенчмарков и моделей нет.
Ключевые факты
- Обучение агентов с подкреплением по скалярной награде теряет детали опыта, например журналы ошибок.
- Недавние подходы передают опыт будущим прогонам через обвязку, но сами артефакты передачи (плейбуки) не обучаются.
- Предложено обучать одну модель трём ролям: генератор действий, рефлектор выводов и составитель плейбука.
- Тестовая среда: зафиксированная обвязка Agentic Context Engineering; плейбуки оцениваются по влиянию на будущие прогоны исполнителя.
- Авторы заявляют более высокое качество на отложенных данных, чем у базовых методов; численных результатов в аннотации нет.
Почему это важно
Идея в том, что обучать нужно не только действия агента, но и опыт, который он записывает для будущих попыток. Сейчас плейбуки и заметки в обвязках обычно составляются без обучения. Авторы предлагают оценивать такие заметки по тому, насколько они помогают следующим прогонам, и оптимизировать это через RL. В названии статьи упомянуто рекурсивное самоулучшение, но аннотация не утверждает, что система реально улучшает себя рекурсивно.
Кому это важно
Исследователям и инженерам, которые обучают LLM-агентов с подкреплением или строят обвязки с памятью, рефлексией и плейбуками. Для тех, кто работает с агентами, это сигнал: управление накопленным опытом можно рассматривать как отдельную обучаемую часть системы.
Как это применить
Прямого применения в аннотации нет: о выпуске кода, данных или готового инструмента не сказано. Практически стоит взять идею: при обучении агента награждать не только результат текущей попытки, но и пользу записанного опыта для следующих. Проверять её нужно на своих задачах и после чтения полной статьи.
Можно ли доверять
Это только аннотация препринта. Авторы заявляют более высокое качество на отложенных данных, чем у базовых методов, но не указывают ни цифр, ни названий бенчмарков, ни базовых методов, ни моделей. Название метода в тексте пропущено. Независимой проверки в источнике нет, поэтому масштаб выигрыша оценить нельзя.
Риски и подводные камни
Метод проверялся в зафиксированной обвязке ACE, и аннотация не говорит, переносится ли он на другие каркасы. Выводы сформулированы осторожно: результаты «предполагают» такой подход к обучению, а не доказывают его. Без численных результатов и сравнения с конкретными базовыми методами заявление о превосходстве остаётся качественным.
«Результаты говорят о том, что обучение агентов должно оптимизировать не только действия в текущем прогоне, но и написанный моделью опыт, который наследуют будущие прогоны.»
— из аннотации статьи на Hugging Face Papers