Multiverse Computing сократила LLM вдвое, подняв MMLU на 23 балла
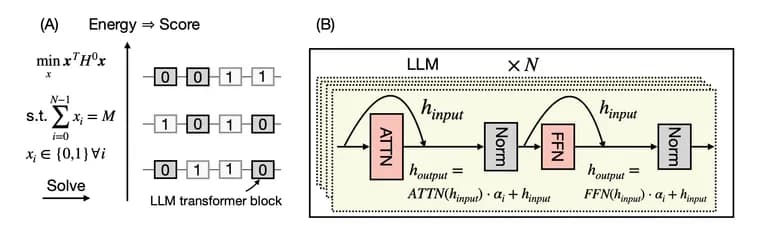
Компания Multiverse Computing (занимается сжатием моделей и квантово-вдохновлёнными вычислениями) опубликовала в блоге на Hugging Face статью "LLM Compression by Block Removal with Constrained Binary Optimization" о новом способе выбирать, какие блоки трансформера удалить при сжатии модели.
Существующие методы (по величине весов, по чувствительности, по "влиянию блока") оценивают важность каждого блока независимо от остальных, в терминах физики это приближение среднего поля. Проблема в том, что блоки не независимы: насколько болезненно удаление 20-го блока, зависит от того, убран ли уже 19-й или 24-й. Чем глубже и разнороднее модель и чем больше блоков нужно убрать разом, тем дороже обходится игнорирование этих взаимодействий.
Метод авторов: каждому блоку присваивается бинарная переменная (0, оставить, 1, удалить), как спин, направленный вниз или вверх. Разложение функции потерь модели в ряд Тейлора второго порядка по этим переменным даёт приближённую матрицу Гессе: диагональ отражает важность каждого блока по отдельности, а недиагональные элементы, попарные взаимодействия между блоками. Задача найти M из N блоков, минимизирующих эту "энергию", формально эквивалентна поиску низкоэнергетических состояний спинового стекла Изинга, системы спинов со всеми парными взаимодействиями и фиксированным числом "поднятых" спинов.
Практическая выгода, в стоимости вычислений. Матрица взаимодействий считается один раз по прямым и обратным проходам на небольшом калибровочном наборе данных, а дальше оценка любой конфигурации удаляемых блоков, это одно дешёвое вычисление энергии, без запуска самой модели и тем более без бенчмарков. Для не слишком больших пространств конфигураций авторы перебирают варианты полным перебором на одном GPU, до десятков миллиардов вариантов; самый тяжёлый разобранный случай, удаление 8 из 80 блоков Llama-3.3-70B (около 29 миллиардов вариантов), занял примерно два дня. Для более крупных пространств задачу сводят к эквивалентной QUBO-форме (quadratic unconstrained binary optimization, квадратичная безусловная бинарная оптимизация) и решают классическими и квантово-вдохновлёнными солверами, включая открытый табу-поиск, который за секунды находит низкоэнергетические состояния даже на самых сложных проверяемых случаях.
Авторы отмечают: им не нужно именно основное состояние (глобальный минимум энергии), достаточно быстро сгенерировать несколько хороших низкоэнергетических состояний, а это гораздо более лёгкая планка. Более того, лучшее решение не всегда совпадает с основным состоянием: на примере Llama-3.1-8B-Instruct при удалении 16 из 32 блоков именно 17-е по счёту возбуждённое состояние первым предлагает убрать блок ближе к началу модели, и после лёгкого дообучения эта конфигурация превосходит основное состояние на нескольких бенчмарках. Это опровергает распространённое предположение, что лучшая обрезка, всегда один сплошной участок блоков из середины или конца модели.
Результаты проверены на трёх моделях, Llama-3.1-8B-Instruct, Qwen3-14B и Llama-3.3-70B-Instruct: метод (в статье он называется CBO) не уступает или превосходит современные базовые методы удаления блоков, причём разрыв растёт с глубиной сжатия. Для Llama-3.3-70B-Instruct без дообучения: при удалении до 24 из 80 блоков CBO примерно на уровне лучшего базового метода (block influence, "влияние блока"), а при 32 и особенно 40 из 80 блоков (то есть сжатии модели вдвое) уверенно вырывается вперёд, при глубочайшем сжатии превосходство на MMLU составляет почти 23 процентных пункта, и CBO обходит базовый метод по всем протестированным бенчмаркам: CBO держит MMLU около 77 пунктов, тогда как у сильнейшего базового метода показатель падает в середину 50-х. Для Qwen3-14B при удалении 12 из 40 блоков CBO опережает базовый метод по MMLU примерно на 10 пунктов. При менее агрессивном сжатии методы сопоставимы: по словам авторов, взаимодействия между блоками решающим образом сказываются именно при глубокой обрезке.
Метод также проверили на гибридной модели NVIDIA-Nemotron-3-Nano-30B-A3B-FP8, которая чередует слои Mamba2, внимания и MoE (mixture-of-experts, смесь экспертов) в неоднородном порядке, без дообучения. Формулировка через попарные взаимодействия не привязана к однородной архитектуре и переносится напрямую: при удалении 2-3 слоёв MoE или 2 слоёв внимания CBO находит конфигурации, которые превосходят block influence на бенчмарках AIME25 и GPQA. Это подтверждает, что избыточность в таких гибридных моделях реальна, но распределена неравномерно, часть экспертных слоёв гораздо легче убрать без потерь, чем другие.
Удаление блоков, часть более широкого компрессионного стека Multiverse Computing, куда также входят квантование, низкоранговое/SVD-сжатие, прунинг по ширине и "лечение" модели после сжатия через дистилляцию знаний. Код метода открыт на GitHub (github.com/CompactifAI/Block_removal_through_constrained_binary_optimization).
Ключевые факты
- Multiverse Computing свела выбор блоков трансформера для удаления к задаче поиска низкоэнергетических состояний спинового стекла Изинга, в отличие от прежних методов, подход учитывает попарные взаимодействия между блоками, а не оценивает каждый блок по отдельности.
- При удалении 40 из 80 блоков Llama-3.3-70B-Instruct (сжатие вдвое, без дообучения) метод даёт почти 23 процентных пункта прироста на MMLU относительно лучшего конкурирующего метода удаления блоков; на Qwen3-14B при удалении 12 из 40 блоков прирост около 10 пунктов.
- Матрица взаимодействий между блоками считается один раз на калибровочных данных; дальше оценка каждой конфигурации, одно дешёвое вычисление энергии. Небольшие пространства перебираются полным перебором на одном GPU (до десятков миллиардов вариантов), большие, решаются классическими и квантово-вдохновлёнными солверами вроде табу-поиска за секунды.
- Лучшее решение не всегда совпадает с основным состоянием: на Llama-3.1-8B-Instruct 17-е по счёту возбуждённое состояние (удаление блока ближе к началу модели) после лёгкого дообучения обошло основное состояние на нескольких бенчмарках.
- Метод проверили на гибридной модели NVIDIA-Nemotron-3-Nano-30B-A3B-FP8 (слои Mamba2, внимания и MoE вперемешку) без дообучения; код открыт на GitHub.
Почему это важно
Большинство методов удаления блоков оценивают каждый блок по отдельности и игнорируют, что удаление одного блока меняет цену удаления другого, Multiverse Computing формализует именно эти попарные взаимодействия через матрицу Гессе и сводит задачу к физической модели спинового стекла Изинга. Практическая отдача не абстрактная: при сжатии Llama-3.3-70B-Instruct вдвое (40 из 80 блоков) метод даёт почти 23 процентных пункта прироста на MMLU над лучшим конкурирующим методом без дообучения, и превосходство растёт именно с глубиной сжатия, там, где взаимодействия между блоками важнее всего.
Кому это важно
Инженерным командам, которые сжимают крупные LLM под ограниченное железо или бюджет инференса и хотят сохранить качество при глубокой обрезке; исследователям в области прунинга и квантово-вдохновлённой оптимизации; разработчикам, которые уже применяют комбинированные компрессионные пайплайны (квантование, низкоранговое сжатие, дистилляция) и ищут более точный способ выбирать, какие блоки убрать в первую очередь.
Как это применить
Матрица попарных взаимодействий между блоками считается один раз, по прямым и обратным проходам на небольшом калибровочном наборе данных, и затем переиспользуется для любого целевого уровня сжатия. Дальше конфигурацию удаляемых блоков ищут либо полным перебором на одном GPU (для небольших моделей это секунды-минуты, но самый тяжёлый разобранный случай занял около двух дней), либо сведением к QUBO-форме и решением классическими или квантово-вдохновлёнными солверами вроде табу-поиска, которые находят хорошие конфигурации за секунды. Код метода открыт на GitHub (github.com/CompactifAI/Block_removal_through_constrained_binary_optimization); метод встраивается в общий компрессионный стек Multiverse наравне с квантованием, низкоранговым сжатием, прунингом по ширине и дистилляцией.
Можно ли доверять
Материал, собственный блог компании-разработчика по её же статье, результаты не проходили независимую проверку за пределами текста. При этом числа конкретные и проверяемые (доли удалённых блоков, значения MMLU, число перебираемых конфигураций), сравнения сделаны на трёх открытых моделях (Llama-3.1-8B-Instruct, Qwen3-14B, Llama-3.3-70B-Instruct) и одной гибридной архитектуре, а код опубликован на GitHub, что позволяет проверить заявленное независимо. В тексте нет имён конкретных авторов статьи и не указана дата публикации, материал подписан только от лица Multiverse Computing.
Риски и подводные камни
Это самостоятельно опубликованный компанией результат: сравнение с базовыми методами выбрано и представлено самими авторами, без независимого воспроизведения. Часть сопоставлений сделана без дообучения, а иллюстративный пример превосходства над "основным состоянием", с лёгким дообучением, так что сравнения не всегда полностью однородны. Метод требует заранее посчитать матрицу Гессе и либо переборный расчёт на GPU (до пары дней на самый тяжёлый случай), либо специализированный солвер, это дополнительные вычислительные затраты до самого сжатия, а решатели типа табу-поиска не гарантируют нахождение истинного минимума энергии, только его хорошее приближение.
«Нам не нужно именно основное состояние. Нужен быстрый способ сгенерировать несколько хороших низкоэнергетических состояний, а это гораздо более лёгкая планка.»
— Multiverse Computing, из блога на Hugging Face