Метод GRACE сократил токены Wan2.1-I2V-14B в 8 раз, задержку, в 11,1
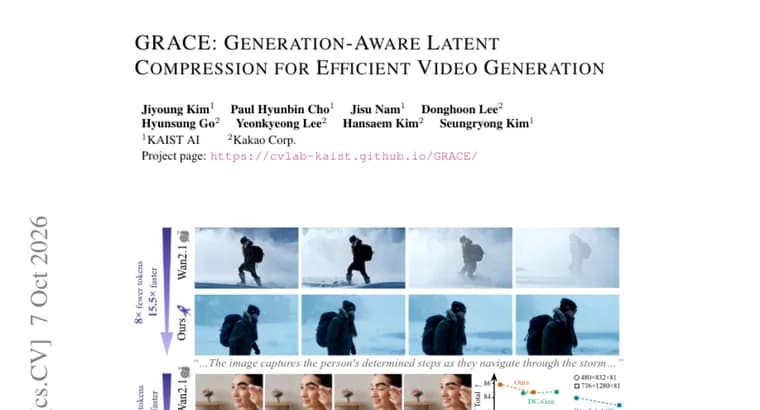
В статье предложен GRACE (Generation-Aware Latent Compression for Efficient Video Generation), двухэтапная схема, которая сильнее сжимает предобученный автокодировщик видео и при этом сохраняет его совместимость с уже обученным диффузионным трансформером (DiT).
Исходная идея, по словам авторов: сильно сжатые видеоавтокодировщики ускоряют диффузионные видеомодели, потому что DiT работает с намного меньшим числом токенов. Но такие автокодировщики трудно обучать. Чем выше степень сжатия, тем хуже реконструкция, а для её восстановления нужно больше каналов, что, как известно, замедляет сходимость DiT. Кроме того, сжатое латентное представление отличается от того, на котором обучался DiT, поэтому предобученный DiT приходится либо обучать с нуля, либо дорого дообучать. Сжатие того же автокодировщика, с которым обучали DiT, на первый взгляд сохраняет совместимость, но оптимизация только под качество реконструкции всё равно сдвигает латентное представление от распределения, которое выучил DiT.
Первый этап GRACE: берут замороженное базовое латентное представление от предобученного энкодера и учат остаточное (residual) представление для информации, потерянной при более сильном сжатии. Сжатое представление выравнивают с предобученным в пространстве признаков замороженного DiT, чтобы автокодировщик оптимизировался именно под генерацию, а не только под реконструкцию.
Второй этап: DiT адаптируют лёгким дообучением и асимметричным шумоподавлением, при котором базовая часть очищается от шума раньше остаточной.
Результат: для Wan2.1-I2V-14B число токенов снижено в 8 раз, а задержка, в 11,1 раза при настройке 480x832x81. Качество генерации по VBench, как заявлено, совпадает с исходным конвейером до сжатия.
Ключевые факты
- GRACE, двухэтапная схема сжатия предобученного видеоавтокодировщика с сохранением совместимости с предобученным DiT.
- Этап 1: замороженное базовое латентное представление плюс обучаемое остаточное; сжатое представление выравнивается с исходным в пространстве признаков замороженного DiT.
- Этап 2: лёгкое дообучение DiT и асимметричное шумоподавление, базовая часть очищается раньше остаточной.
- Для Wan2.1-I2V-14B заявлено сокращение числа токенов в 8 раз и задержки в 11,1 раза при 480x832x81.
- Качество генерации по VBench, по заявлению авторов, совпадает с исходным конвейером до сжатия.
Почему это важно
Число токенов, с которыми работает DiT, напрямую определяет стоимость генерации видео. Сильное сжатие автокодировщика даёт ускорение, но обычно ломает совместимость с уже обученным DiT и требует переобучения с нуля или дорогой адаптации. GRACE пытается убрать это препятствие: сжать автокодировщик, не выбрасывая предобученный DiT. Заявленный результат, сокращение токенов в 8 раз и задержки в 11,1 раза без потери качества по VBench.
Кому это важно
Исследователям и инженерам, которые занимаются видеогенерацией на основе диффузионных трансформеров и ускорением инференса, а также тем, кто хочет удешевить уже обученные большие видеомодели, не обучая их заново.
Как это применить
Это исследовательская работа, а не готовый инструмент. Практическая идея в том, чтобы сохранять замороженное базовое латентное представление, доучивать остаточное и выравнивать их в пространстве признаков замороженного DiT, а затем слегка дообучать DiT с асимметричным шумоподавлением. О выпуске кода или весов в источнике не говорится.
Можно ли доверять
Все цифры, заявления самих авторов из описания статьи. Приведены только коэффициенты: сокращение токенов в 8 раз и задержки в 11,1 раза. Сами значения VBench, оборудование и абсолютные времена не указаны, так что независимо проверить результат по этому тексту нельзя.
Риски и подводные камни
Результаты приведены только для Wan2.1-I2V-14B, переносимость на другие модели из текста неясна. Не указаны степень сжатия автокодировщика, число каналов и стоимость дообучения, поэтому оценить реальную экономию на этапе адаптации нельзя. Утверждение о равном качестве опирается на VBench, а подробностей о том, при каких условиях измерена задержка, нет.