Microsoft Research Asia открыла Agent Lightning v1.0: обучение агентов в ~3500 строк
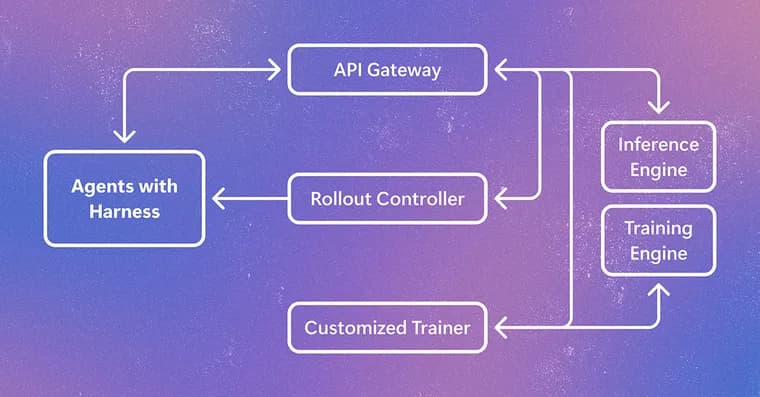
Исследователи Microsoft Research Asia представили парадигму Harnessed Agentic RL (обучение агентов с подкреплением на реальной обвязке) и открыли исходный код полностью переработанного Agent Lightning v1.0. Идея: какая обвязка агента (agent harness) используется при развёртывании, та же напрямую участвует в обучении с подкреплением. Не нужно заново реализовывать агента внутри обучающего фреймворка, из-за чего обучаемый агент оказывается «не совсем тем», что потом работает в деле.
Проблема в авторской трактовке такая. Традиционное агентное RL предполагает, что цикл взаимодействия со средой принадлежит обучающему фреймворку: модель выдаёт действие, среда возвращает наблюдение, оно добавляется в контекст, и весь прогон (rollout) укладывается в одну непрерывную последовательность токенов. Так были устроены ранние системы verl, AReaL и slime. Но у реальных обвязок, mini-SWE-agent, OpenHands, OpenCode, Claude Code, Codex, собственное управление контекстом, протоколы инструментов и зависимости. Переписывать такую обвязку для обучения дорого, а переписанный агент может вести себя иначе, чем развёрнутый.
Agent Lightning ставит между агентом и моделью прокси для LLM. Агент работает как раньше: достаточно направить его адрес обращения к модели на Agent Lightning, и фреймворк видит и записывает все вызовы модели. По словам авторов, для существующей обвязки этого обычно хватает, чтобы быстро подключиться к RL-обучению.
Весь фреймворк, около 3500 строк кода, три основных компонента. API Gateway хранит прогоны, модели и события и служит OpenAI-совместимым прокси; он связывает каждый вызов модели с прогоном и записывает промпты, ответы и логарифмы вероятностей. Rollout Controller запускает агентов как локальные процессы или как стандартные задания Kubernetes, отделяя выполнение агента от тренера. Customized Trainer, построенный на verl, создаёт прогоны, ждёт их завершения, собирает образцы и через адаптер собирает итоговые обучающие образцы.
Поскольку цикл ведёт обвязка, обучающая система видит лишь пары запрос/ответ к LLM, и один прогон может разбиться на разное число образцов. Отсюда четыре трудности: (1) повторная токенизация и склейка образцов, обвязки хранят контекст текстом, а обучению нужны токены, выбранные при прогоне; повторная токенизация сдвигает границы токенов, и соседние вызовы не всегда удаётся слить в один образец; (2) расчёт преимущества (advantage), подагенты, суммаризация контекста и повторная токенизация дробят прогон, и при расчёте на уровне образцов прогоны с большим числом образцов учитываются многократно; (3) нормализация потерь, усреднение по числу образцов даёт больший вес прогонам с большим их числом, хотя оно часто лишь следствие поведения обвязки; (4) планирование обучающего бэкенда, число и длина образцов известны только после завершения обвязки, а число GPU и конфигурации параллелизма обычно фиксированы.
Ещё одно новшество, Collocated Async RL: прогоны и обновление модели делят один и тот же набор GPU. Синхронное RL ждёт самого медленного агента в пачке и простаивает, полностью асинхронное повышает загрузку, но требует раздельных пулов GPU. Когда собрано достаточно прогонов, API Gateway перестаёт принимать новые запросы, ждёт завершения текущих, затем идёт обновление, после которого прогоны возобновляются; для обвязки это прозрачно. В экспериментах такой подход дал примерно двукратное ускорение «от начала до конца» по сравнению с синхронным RL при меньшем числе GPU, чем у обычного асинхронного RL.
На Kubernetes авторы делают ставку, потому что множество одновременных агентов потребляет много процессора, памяти и вычислений, а другие фреймворки нередко размещают агентов на коммерческих песочницах вроде Modal Sandbox или E2B, где стоимость быстро растёт с масштабом. Agent Lightning v1.0 запускает их как обычные задания Kubernetes на собственных или облачных кластерах либо на локальной инфраструктуре. По утверждению авторов, это эффективнее использует имеющиеся ресурсы, удешевляет крупные прогоны и оставляет весь конвейер открытым и воспроизводимым.
Проверка, полный конвейер для кодингового агента на SWE-smith, mini-SWE-agent и Qwen3.5-9B: очистка данных, построение сред, защита от взлома награды (reward hacking) и RL-обучение. Обучающая выборка, около 6000 образцов на основе открытого набора данных, крупных вычислений не требуется. Только за счёт RL Qwen3.5-9B вырос с 41,8% до 56,4% Pass@1 на SWE-bench Verified, абсолютный прирост 14,6 процентного пункта. Эксперименты также подтвердили анализ двух трудностей: расчёт преимущества и нормализация потерь на уровне прогона дают более высокую награду на валидации и более стабильную энтропию политики, чем обработка на уровне образцов.
Ключевые факты
- Microsoft Research Asia предложила парадигму Harnessed Agentic RL и открыла Agent Lightning v1.0: та же обвязка агента, что используется в деле, напрямую участвует в обучении с подкреплением.
- Весь фреймворк занимает около 3500 строк кода; три компонента, API Gateway (OpenAI-совместимый прокси для LLM), Rollout Controller и Customized Trainer на базе verl.
- Агенты запускаются как стандартные задания Kubernetes, без платных коммерческих песочниц; Collocated Async RL в экспериментах дал около двукратного ускорения относительно синхронного RL при меньшем числе GPU, чем у обычного асинхронного RL.
- Пример с кодинговым агентом: Qwen3.5-9B вырос с 41,8% до 56,4% Pass@1 на SWE-bench Verified (+14,6 п.п. абсолютно) на выборке около 6000 образцов.
- Названы четыре трудности обучения на реальных обвязках: повторная токенизация и склейка образцов, расчёт преимущества, нормализация потерь, планирование бэкенда.
Почему это важно
Агенты всё больше зависят от обвязки, которая координирует модель снаружи: управление контекстом, инструменты, среда исполнения. Обычно для RL-обучения агента приходится переписывать внутри обучающего фреймворка, а это дорого и порождает расхождение между обучаемым и развёрнутым агентом. Agent Lightning v1.0 предлагает обучать агента на той самой обвязке, подменяя лишь адрес обращения к модели, и делает это в компактной кодовой базе (около 3500 строк), которую, по словам авторов, можно понять, изменить и расширить.
Кому это важно
Командам, которые строят агентов на готовых обвязках (авторы упоминают mini-SWE-agent, OpenHands, OpenCode, Claude Code, Codex) и хотят дообучать модель с подкреплением. Также тем, у кого уже есть кластеры Kubernetes и кто не хочет платить за коммерческие песочницы вроде Modal Sandbox или E2B, и исследователям, изучающим агентное RL на небольших моделях.
Как это применить
По описанию авторов, для существующей обвязки обычно достаточно направить адрес обращения к модели на прокси Agent Lightning. Прогоны можно запускать локальными процессами или как задания Kubernetes на собственном, облачном или локальном кластере; тренер построен на verl. В качестве образца в блоге описан конвейер для кодингового агента на SWE-smith, mini-SWE-agent и Qwen3.5-9B с очисткой данных, построением сред, защитой от взлома награды и RL-обучением на выборке около 6000 образцов. Лицензия кода в тексте не названа, поэтому условия использования стоит проверить в репозитории.
Можно ли доверять
Источник, блог самих исследователей Microsoft Research Asia, то есть изложение собственной работы, а все результаты, их собственные. Цифры конкретны: рост Qwen3.5-9B с 41,8% до 56,4% Pass@1 на SWE-bench Verified, абсолютный прирост 14,6 п.п. Но в тексте нет сравнения этого результата с другими моделями или методами обучения, нет данных о числе GPU, времени и стоимости эксперимента. Двукратное ускорение Collocated Async RL приведено без указания модели, задачи и оборудования. Имена отдельных авторов в тексте не названы.
Риски и подводные камни
Сами авторы описывают четыре трудности обучения на реальных обвязках: сдвиг границ токенов при повторной токенизации мешает склеивать вызовы в один образец; дробление прогона на образцы искажает расчёт преимущества и веса прогонов в потерях; число и длина образцов становятся известны только после завершения работы обвязки, тогда как конфигурация GPU фиксирована. Обработка на уровне прогона, по данным их экспериментов, помогает, но результаты показаны на одном примере с кодинговым агентом. Заявленные выгоды по стоимости Kubernetes в сравнении с коммерческими песочницами в тексте цифрами не подкреплены.